Rechnungs Matching programmieren: Bankumsätze automatisch offenen Posten zuordnen
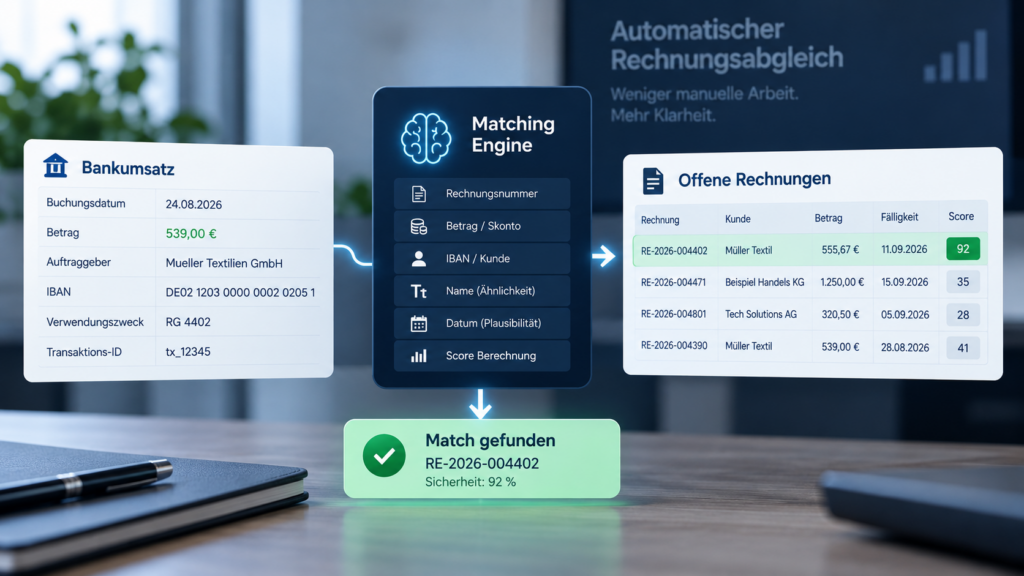
Ein Zahlungseingang über 539 Euro geht auf dem Bankkonto ein.
Im Verwendungszweck steht:
RG 4402Im ERP befindet sich eine offene Rechnung über 555,67 Euro. Der Kunde heißt dort Müller Textil, auf dem Kontoauszug erscheint dagegen Mueller Textilien GmbH. Zusätzlich sind drei Prozent Skonto vereinbart.
Für einen Menschen ist die Zuordnung relativ schnell klar. Für eine Software ist sie das zunächst nicht.
Genau hier beginnt das eigentliche Rechnungs Matching. Die Anwendung muss aus mehreren möglicherweise unvollständigen Informationen ableiten, welcher offene Posten zu einer Banktransaktion gehört und wie sicher diese Zuordnung ist.
Im Beitrag Zahlungseingänge automatisch offenen Rechnungen zuordnen wird beschrieben, wie ein solcher Prozess fachlich aussehen kann.
Die technische Frage davor, also wie Banktransaktionen überhaupt automatisiert in die eigene Anwendung gelangen, wird im Beitrag Bankumsätze per API abrufen: PSD2, FinTS oder EBICS? behandelt.
In diesem Artikel geht es um den Schritt dazwischen: Wie findet eine Software zu einer Banktransaktion möglichst zuverlässig die richtige offene Rechnung?
Warum ein einfacher Vergleich des Betrags nicht ausreicht
Die einfachste denkbare Lösung wäre ein Datenbank Lookup nach dem Zahlungsbetrag.
SELECT *
FROM invoices
WHERE status = 'open'
AND amount = 539.00;
In kleinen Testdaten kann das sogar funktionieren. In der Realität entstehen allerdings schnell Mehrdeutigkeiten.
Mehrere Rechnungen können denselben Betrag haben. Kunden können Skonto abziehen. Rechnungen können teilweise bezahlt werden. Ein Kunde kann mehrere Rechnungen mit einer einzigen Überweisung begleichen. Zusätzlich können Rundungen oder falsche Beträge auftreten.
Auch der Verwendungszweck ist nicht immer zuverlässig. Aus einer Rechnungsnummer wie RE-2026-004402 kann beim Kunden beispielsweise RG 4402, Rechnung 004402 oder lediglich Danke werden.
Ein produktiver Rechnungsabgleich sollte deshalb nicht nach einem einzigen Merkmal entscheiden. Er sollte mehrere Signale kombinieren.
Zuerst braucht es ein einheitliches Datenmodell
Bevor das Matching beginnt, sollten Banktransaktionen unabhängig von ihrer ursprünglichen Quelle in ein einheitliches Format übertragen werden.
Wie die Bankdaten technisch abgerufen werden, sollte für den Matching Algorithmus keine Rolle spielen.
{
  "id": "tx_12345",
  "bookingDate": "2026-09-04",
  "amount": 539.00,
  "currency": "EUR",
  "debtorName": "Mueller Textilien GmbH",
  "debtorIban": "DE02120300000000202051",
  "reference": "RG 4402"
}
Die dazugehörige Rechnung könnte so aussehen:
{
  "id": "invoice_4402",
  "number": "RE-2026-004402",
  "customerId": "customer_27",
  "customerName": "Müller Textil",
  "amount": 555.67,
  "currency": "EUR",
  "invoiceDate": "2026-08-12",
  "dueDate": "2026-09-11",
  "discountPercent": 3,
  "status": "open"
}
Aus diesen beiden Objekten müssen anschließend Merkmale erzeugt werden, anhand derer eine Zuordnung bewertet werden kann.
Schritt 1: Nicht jede Transaktion mit jeder Rechnung vergleichen
Angenommen, ein Unternehmen hat 80.000 Rechnungen in seiner Datenbank.
Es wäre unnötig, einen neuen Zahlungseingang mit jeder einzelnen Rechnung zu vergleichen. Stattdessen sollte zunächst eine möglichst kleine Kandidatenmenge erzeugt werden.
Für einen eingehenden Betrag in Euro könnten beispielsweise nur Rechnungen betrachtet werden, die:
- noch offen sind
- dieselbe Währung besitzen
- zeitlich grundsätzlich zur Zahlung passen
- einen plausiblen offenen Betrag besitzen
- nicht storniert wurden
Aus 80.000 Rechnungen werden dadurch vielleicht noch 20 oder 50 Kandidaten.
SELECT *
FROM invoices
WHERE status = 'open'
AND currency = 'EUR'
AND invoice_date <= '2026-09-04';
Wenn die IBAN bereits einem Kunden zugeordnet werden kann, lassen sich beispielsweise zunächst nur dessen offene Rechnungen betrachten.
Banktransaktion
      |
      v
IBAN bekannt?
      |
      v
Kunde ermitteln
      |
      v
Nur offene Rechnungen
dieses Kunden betrachten
Je besser diese Vorauswahl funktioniert, desto einfacher wird der eigentliche Matching Schritt.
Schritt 2: Rechnungsnummern im Verwendungszweck erkennen
Eine Rechnungsnummer im Verwendungszweck ist normalerweise eines der stärksten Signale.
Das Problem besteht darin, dass Kunden die Nummer nicht immer exakt übernehmen.
Aus RE-2026-004402 kann beispielsweise RE 2026 004402, Rechnung: 4402 oder RG4402 werden.
Werte zuerst normalisieren
Vor dem Vergleich können beide Werte normalisiert werden.
Aus RE-2026/004402 wird beispielsweise RE2026004402.
Und aus Zahlung Rechnung RE 2026 004402 vielen Dank wird ZAHLUNGRECHNUNGRE2026004402VIELENDANK.
import re

def normalize(value):
    value = value.upper()
    return re.sub(r'[^A-Z0-9]', '', value)

invoice_number = normalize("RE-2026-004402")
reference = normalize("Zahlung RE 2026 004402")

if invoice_number in reference:
    print("Rechnungsnummer gefunden")
In der Praxis können zusätzlich alternative Schreibweisen berücksichtigt werden. Wenn die interne Rechnungsnummer RE-2026-004402 lautet, könnte auch nach dem signifikanten Bestandteil 004402 gesucht werden.
Dabei ist Vorsicht notwendig. Je kürzer eine Referenz wird, desto höher wird die Wahrscheinlichkeit eines zufälligen Treffers.
Schritt 3: Den Zahlungsbetrag bewerten
Der Betrag ist ebenfalls ein starkes Signal. Wenn eine Rechnung über 539 Euro offen ist und genau 539 Euro eingehen, spricht das für eine Zuordnung.
Aber ein nicht exakt übereinstimmender Betrag bedeutet nicht automatisch, dass die Rechnung falsch ist.
Skonto berücksichtigen
Nehmen wir eine Rechnung über 555,67 Euro mit drei Prozent Skonto.
Rechnungsbetrag       555,67 €
Skonto 3 %             16,67 €
Zahlbetrag            539,00 €
Ein Algorithmus sollte deshalb nicht ausschließlich prüfen, ob Zahlung und Rechnungsbetrag exakt identisch sind. Er sollte auch einen gültigen Skontobetrag erkennen.
Zusätzlich sollte geprüft werden, ob der Zahlungseingang innerhalb der vereinbarten Skontofrist erfolgt ist.
Rundungsdifferenzen berücksichtigen
Auch kleine Rundungsabweichungen können vorkommen.
difference = abs(transaction.amount - invoice.amount)

if difference == 0:
    score += 30
elif difference <= 0.02:
    score += 20
Wie groß eine solche Toleranz sein darf, hängt vom jeweiligen Prozess ab. Die Regel sollte deshalb konfigurierbar sein und nicht tief im Programmcode versteckt werden.
Schritt 4: Die IBAN des Zahlungspflichtigen nutzen
Wenn ein Kunde bereits früher bezahlt hat, kann seine IBAN ein sehr starkes Merkmal sein.
DE021203...
    |
    v
Kunde 4711
    |
    v
Offene Rechnungen
von Kunde 4711
Das reduziert die Kandidatenmenge erheblich.
Allerdings darf auch die IBAN nicht als alleinige Wahrheit betrachtet werden. Unternehmen besitzen mehrere Bankkonten. Konzerne bezahlen Rechnungen zentral. Zahlungen können auch von anderen Konten stammen.
Eine unbekannte IBAN bedeutet deshalb nicht automatisch, dass kein Match möglich ist. Umgekehrt ist eine bekannte IBAN ein sehr gutes zusätzliches Signal.
Schritt 5: Namen normalisieren und ähnlichkeitsbasiert vergleichen
Firmennamen sind besonders fehleranfällig.
Im ERP steht beispielsweise Müller Textil GmbH. Auf dem Kontoauszug steht MUELLER TEXTILIEN GMBH.
Ein exakter String Vergleich würde hier fehlschlagen.
Vor dem Vergleich können Namen deshalb normalisiert werden.
- Groß und Kleinschreibung vereinheitlichen
- Umlaute vereinheitlichen
- Satzzeichen entfernen
- doppelte Leerzeichen entfernen
- Rechtsformen vereinheitlichen oder entfernen
- häufige Zusätze ignorieren
Aus Müller Textil GmbH könnte beispielsweise MUELLER TEXTIL werden. Aus Mueller Textilien GmbH wird MUELLER TEXTILIEN.
Anschließend kann eine String Ähnlichkeit berechnet werden. Dafür gibt es verschiedene Verfahren, zum Beispiel Levenshtein Distanz oder Token basierte Ähnlichkeitsmaße.
MUELLER TEXTIL
MUELLER TEXTILIEN

Similarity: 0.91
Dieser Wert entscheidet nicht allein über die Rechnung. Er ist lediglich ein weiteres Signal.
Schritt 6: Mehrere Signale zu einem Score kombinieren
Statt mit vielen einzelnen Ja Nein Entscheidungen zu arbeiten, kann jede mögliche Zuordnung einen Score erhalten.
Rechnungsnummer exakt erkannt        +50
Betrag exakt                         +30
gültiger Skontobetrag                +25
IBAN bekannt                         +15
Name sehr ähnlich                    +10
Zahlungsdatum plausibel               +5
Für eine konkrete Zahlung könnte das Ergebnis beispielsweise so aussehen:
Rechnungsnummer erkannt              +50
gültiger Skontobetrag                +25
IBAN unbekannt                         0
Name sehr ähnlich                    +10
Zahlungsdatum plausibel               +5
-----------------------------------------
Gesamt                                90
Anschließend können Schwellenwerte definiert werden.
Score ab 80
Automatisch zuordnen

Score 50 bis 79
Zuordnung vorschlagen

Score unter 50
Nicht automatisch zuordnen
Die konkreten Zahlen sind keine allgemein gültige Empfehlung. Sie müssen anhand realer Daten und des jeweiligen Risikos angepasst werden.
Das Grundprinzip bleibt gleich: Je mehr unabhängige Signale dieselbe Rechnung bestätigen, desto höher kann die Sicherheit der Zuordnung sein.
Nicht nur den besten Kandidaten betrachten
Ein häufiger Fehler besteht darin, einfach die Rechnung mit dem höchsten Score zu wählen.
Rechnung A: Score 91
Rechnung B: Score 90
Rechnung A hat zwar den höheren Score. Die Zuordnung ist trotzdem offensichtlich nicht eindeutig.
Anders sieht es hier aus:
Rechnung A: Score 96
Rechnung B: Score 42
Neben dem absoluten Score sollte deshalb auch der Abstand zum zweitbesten Kandidaten berücksichtigt werden.
if best_score >= 80 and best_score - second_best_score >= 20:
    automatically_assign()
else:
    require_review()
Dadurch wird verhindert, dass die Anwendung bei zwei fast identischen Kandidaten willkürlich einen davon auswählt.
Teilzahlungen
Eine Rechnung muss nicht vollständig bezahlt werden.
Offene Rechnung       1.000 €
Zahlung                 500 €
Restbetrag               500 €
Hier sollte die Transaktion nicht als vollständige Begleichung markiert werden.
invoice.amount          1000.00
invoice.paid_amount      500.00
invoice.open_amount      500.00
invoice.status          PARTIALLY_PAID
Das Matching kann trotzdem eindeutig sein, wenn Rechnungsnummer, IBAN und Kunde passen.
Die Bewertung des Matches und die buchhalterische Behandlung der Zahlung sollten deshalb zwei getrennte Schritte sein.
Sammelzahlungen
Komplexer wird es, wenn ein Kunde mehrere Rechnungen mit einer einzigen Überweisung bezahlt.
Rechnung A       500 €
Rechnung B       400 €
Rechnung C       600 €

Überweisung    1.500 €
Hier entspricht der Zahlungseingang keiner einzelnen Rechnung. Die Summe mehrerer offener Rechnungen entspricht aber exakt dem Zahlungsbetrag.
Technisch entsteht damit ein kombinatorisches Problem. Die Anwendung muss herausfinden, welche Kombination offener Rechnungen den Zahlungsbetrag ergibt. Dieses Problem ähnelt dem bekannten Subset Sum Problem.
Bei wenigen offenen Rechnungen ist das noch einfach. Bei einem Kunden mit sehr vielen offenen Posten möchte man allerdings nicht blind jede mögliche Kombination ausprobieren.
Deshalb sollte die Kandidatenmenge auch hier zunächst eingeschränkt werden.
- Rechnungen desselben Kunden
- Rechnungen innerhalb eines plausiblen Zeitraums
- Referenzen im Verwendungszweck
- Rechnungsnummern in einer Zahlungsmitteilung
- exakt passender Gesamtbetrag
Überzahlungen
Auch das Gegenteil kommt vor.
Rechnung       539,00 €
Zahlung        559,00 €
Die Software sollte nicht versuchen, die Differenz zwangsläufig durch einen anderen offenen Posten zu erklären.
Mögliche Ursachen sind Tippfehler, eine zusätzliche Rechnung, eine Vorauszahlung, ein bewusstes Guthaben oder eine falsche Zahlungsreferenz.
Eine robuste Matching Engine sollte deshalb zwischen der Frage nach der wahrscheinlichsten Rechnung und der Frage nach der korrekten Verbuchung unterscheiden.
Doppelte Transaktionen vermeiden
Banktransaktionen werden häufig regelmäßig importiert. Dabei muss verhindert werden, dass dieselbe Transaktion mehrfach verarbeitet wird.
Dafür sollte jede Transaktion möglichst eine stabile technische ID besitzen.
{
  "externalTransactionId": "bank_tx_abc123",
  "processedAt": "2026-09-04T14:21:00"
}
Beim nächsten Import wird zunächst geprüft, ob die Transaktion bereits vorhanden ist.
Falls die Bank keine ausreichend stabile ID liefert, kann alternativ ein eigener Fingerprint aus mehreren Merkmalen erzeugt werden. Dabei muss berücksichtigt werden, dass theoretisch zwei identische Zahlungen existieren können.
Was passiert bei einer Stornierung oder Rückzahlung?
Auch eine bereits verarbeitete Zahlung kann später wieder relevant werden. Beispielsweise durch Rücküberweisung, Rücklastschrift, Korrekturbuchung oder eine fehlerhafte ursprüngliche Zuordnung.
Deshalb sollte eine Zuordnung nicht einfach nur den Rechnungsstatus von open auf paid setzen.
Besser ist ein nachvollziehbares Datenmodell.
Banktransaktion
      |
      v
Payment Allocation
      |
      v
Rechnung
Die Zuordnung selbst kann als eigener Datensatz gespeichert werden.
{
  "transactionId": "tx_12345",
  "invoiceId": "invoice_4402",
  "amount": 539.00,
  "score": 90,
  "method": "automatic",
  "createdAt": "2026-09-04T14:22:00"
}
Dadurch bleibt nachvollziehbar, warum eine Rechnung als bezahlt oder teilweise bezahlt betrachtet wurde.
Wann sollte KI eingesetzt werden?
Nicht jeder Teil des Rechnungsabgleichs benötigt künstliche Intelligenz.
Viele Informationen lassen sich zuverlässiger und nachvollziehbarer mit klassischen Regeln verarbeiten.
Eine exakte Rechnungsnummer braucht kein Sprachmodell. Ein exakter Betrag braucht kein Sprachmodell. Eine bekannte IBAN ebenfalls nicht.
Rechnungsnummer vorhanden?
          |
          v
        Regel
          |
          v
Betrag plausibel?
          |
          v
        Regel
          |
          v
IBAN bekannt?
          |
          v
        Regel
          |
          v
Name ähnlich?
          |
          v
Fuzzy Matching
          |
          v
Immer noch unklar?
          |
          v
KI oder manuelle Prüfung
KI kann interessant werden, wenn Informationen unstrukturiert oder sprachlich schwierig sind.
Beispielsweise könnte im Verwendungszweck stehen:
Ausgleich August abzgl Rekla zu Auftrag 1841Ein Sprachmodell könnte daraus zusätzliche Hinweise ableiten. Die Entscheidung sollte trotzdem nicht allein aufgrund einer solchen Interpretation automatisiert werden.
Gerade in buchhalterischen Prozessen ist Nachvollziehbarkeit wichtig. Deshalb bietet sich eine Kombination aus deterministischen Regeln, statistischen Verfahren und optionaler KI an.
Eine einfache Matching Funktion
Ein stark vereinfachter Prototyp könnte folgendermaßen aussehen:
def calculate_score(transaction, invoice):
    score = 0

    if invoice_number_matches(
        transaction.reference,
        invoice.number
    ):
        score += 50

    if transaction.amount == invoice.amount:
        score += 30

    elif matches_discount_amount(
        transaction,
        invoice
    ):
        score += 25

    if transaction.debtor_iban in invoice.customer.known_ibans:
        score += 15

    similarity = compare_names(
        transaction.debtor_name,
        invoice.customer.name
    )

    score += similarity * 10

    if payment_date_is_plausible(
        transaction.booking_date,
        invoice
    ):
        score += 5

    return score
Anschließend wird nicht nur ein Kandidat bewertet. Alle plausiblen Kandidaten erhalten einen Score.
results = []

for invoice in candidate_invoices:
    results.append({
        "invoice": invoice,
        "score": calculate_score(transaction, invoice)
    })

results.sort(
    key=lambda result: result["score"],
    reverse=True
)
Danach kann entschieden werden, ob automatisch zugeordnet werden darf.
best = results[0]
second = results[1] if len(results) > 1 else None

if (
    best["score"] >= 80
    and (
        second is None
        or best["score"] - second["score"] >= 20
    )
):
    assign_automatically(best["invoice"])
else:
    request_manual_review()
Das ist noch keine produktionsreife Buchhaltungssoftware. Es zeigt aber das Grundprinzip gut.
Regeln sollten erklärbar bleiben
Ein großer Vorteil eines solchen Score Modells besteht darin, dass die Entscheidung nachvollziehbar bleibt.
Statt nur anzuzeigen, dass eine Rechnung automatisch zugeordnet wurde, kann die Anwendung erklären:
Zuordnung zu RE-2026-004402

Rechnungsnummer erkannt       +50
Skontobetrag erkannt          +25
Name sehr ähnlich             +10
Zahlungsdatum plausibel        +5

Gesamt                         90
Für einen Sachbearbeiter ist das wesentlich hilfreicher. Er sieht sofort, warum die Software eine bestimmte Rechnung vorgeschlagen hat.
Human in the Loop statt Automatisierung um jeden Preis
Das Ziel sollte nicht sein, jede einzelne Zahlung automatisch zuzuordnen.
Das Ziel sollte sein, möglichst viele eindeutige Fälle automatisch zu bearbeiten und die verbleibenden Fälle sinnvoll vorzubereiten.
Banktransaktion
      |
      v
Matching Engine
      |
      v
Confidence Score
      |
      + automatisch zuordnen
      + Vorschlag anzeigen
      + ungeklärt lassen
Wenn eine Zahlung offensichtlich zu einer Rechnung gehört, spart die Automatisierung manuelle Arbeit.
Wenn zwei Rechnungen praktisch gleich wahrscheinlich sind, sollte die Anwendung dagegen nicht raten.
Ein falsch automatisch zugeordneter Zahlungseingang kann mehr Aufwand verursachen als eine bewusst offengelassene Transaktion.
Ein sinnvoller Aufbau der Anwendung
Bank
 |
 v
Bank Adapter
 |
 v
Transaction Normalizer
 |
 v
Candidate Generator
 |
 v
Feature Extraction
 |
 + Rechnungsnummer
 + Betrag
 + Skonto
 + IBAN
 + Name
 + Datum
 |
 v
Scoring
 |
 v
Decision Engine
 |
 + Automatisch
 + Review
 + Ungeklärt
 |
 v
Payment Allocation
 |
 v
Rechnung
Der Bank Adapter kümmert sich nur darum, Banktransaktionen in die Anwendung zu bekommen.
Wie dieser Teil über PSD2, FinTS oder EBICS umgesetzt werden kann, wird im Artikel Bankumsätze per API abrufen: PSD2, FinTS oder EBICS? beschrieben.
Der Transaction Normalizer übersetzt die unterschiedlichen Bankdaten in ein einheitliches internes Format. Der Candidate Generator sucht passende offene Rechnungen. Die Feature Extraction berechnet die einzelnen Signale. Das Scoring bewertet jeden Kandidaten. Die Decision Engine entscheidet schließlich, ob automatisch zugeordnet werden darf oder ein Mensch den Fall prüfen sollte.
Diese Trennung hat einen weiteren Vorteil: Jeder Teil lässt sich separat testen.
Mit echten Fällen testen
Für einen Prototypen würde ich nicht nur künstlich einfache Testdaten verwenden.
Interessanter sind Fälle, die auch im tatsächlichen Zahlungsverkehr vorkommen.
- exakte Rechnungsnummer und exakter Betrag
- keine Rechnungsnummer, aber bekannte IBAN und passender Betrag
- Rechnungsnummer vorhanden und Skonto korrekt abgezogen
- Betrag passt zu zwei Rechnungen und weitere Informationen fehlen
- Name leicht unterschiedlich, Betrag und Rechnungsnummer stimmen
- Teilzahlung
- Sammelzahlung für mehrere Rechnungen
- unbekannter Absender, kein Verwendungszweck und mehrere mögliche Rechnungen
Gerade der letzte Fall ist wichtig.
Eine gute Matching Engine zeichnet sich nicht nur dadurch aus, dass sie richtige Zuordnungen findet. Sie sollte auch erkennen, wann die vorhandenen Informationen für eine sichere Entscheidung nicht ausreichen.
Fazit
Ein automatischer Rechnungsabgleich ist weniger ein einzelner Algorithmus als eine Kombination mehrerer kleiner Entscheidungen.
Rechnungsnummer, Betrag, Skonto, IBAN, Name und Zahlungsdatum liefern jeweils Hinweise. Keines dieser Merkmale ist für sich allein immer zuverlässig. Zusammen ergeben sie allerdings ein starkes Signal.
Eine robuste Lösung erzeugt deshalb zunächst eine kleine Menge plausibler Rechnungen, bewertet anschließend mehrere Merkmale und berechnet daraus eine Sicherheit für jede mögliche Zuordnung.
Eindeutige Fälle können automatisch verarbeitet werden. Unsichere Fälle werden als Vorschlag angezeigt oder bleiben bewusst ungeklärt.
Wer den gesamten Prozess von Anfang an betrachten möchte, findet die fachliche Einordnung im Beitrag Zahlungseingänge automatisch offenen Rechnungen zuordnen.
Wenn Sie den automatischen Abgleich von Bankumsätzen und offenen Posten testen möchten und noch nicht wissen, wie viel sich mit Regeln, Fuzzy Matching oder KI zuverlässig automatisieren lässt, ist ein kleiner Prototyp meist der sinnvollste erste Schritt.
In 15 Minuten lässt sich unverbindlich klären, welche Matching Logik zu Ihren Daten, Sonderfällen und bestehenden Systemen passt. Zum Erstgespräch.
Zusammenarbeit
Individuelle KI- und Automatisierungslösungen, passend zu Prozess, Datenrisiko und Kosten.
Kontakt aufnehmen →Blog
Neue Artikel per E-Mail. Keine Werbung.