Ein Zahlungseingang über 539 Euro geht auf dem Bankkonto ein.
Im Verwendungszweck steht:
RG 4402
Im ERP befindet sich eine offene Rechnung über 555,67 Euro. Der Kunde heißt dort Müller Textil, auf dem Kontoauszug erscheint dagegen Mueller Textilien GmbH. Zusätzlich sind drei Prozent Skonto vereinbart.
Für einen Menschen ist die Zuordnung relativ schnell klar. Für eine Software ist sie das zunächst nicht.
Genau hier beginnt das eigentliche Rechnungs Matching. Die Anwendung muss aus mehreren möglicherweise unvollständigen Informationen ableiten, welcher offene Posten zu einer Banktransaktion gehört und wie sicher diese Zuordnung ist.
In diesem Artikel geht es um den Schritt dazwischen: Wie findet eine Software zu einer Banktransaktion möglichst zuverlässig die richtige offene Rechnung?
Warum ein einfacher Vergleich des Betrags nicht ausreicht
Die einfachste denkbare Lösung wäre ein Datenbank Lookup nach dem Zahlungsbetrag.
SELECT *
FROM invoices
WHERE status = 'open'
AND amount = 539.00;
In kleinen Testdaten kann das sogar funktionieren. In der Realität entstehen allerdings schnell Mehrdeutigkeiten.
Mehrere Rechnungen können denselben Betrag haben. Kunden können Skonto abziehen. Rechnungen können teilweise bezahlt werden. Ein Kunde kann mehrere Rechnungen mit einer einzigen Überweisung begleichen. Zusätzlich können Rundungen oder falsche Beträge auftreten.
Auch der Verwendungszweck ist nicht immer zuverlässig. Aus einer Rechnungsnummer wie RE-2026-004402 kann beim Kunden beispielsweise RG 4402, Rechnung 004402 oder lediglich Danke werden.
Ein produktiver Rechnungsabgleich sollte deshalb nicht nach einem einzigen Merkmal entscheiden. Er sollte mehrere Signale kombinieren.
Zuerst braucht es ein einheitliches Datenmodell
Bevor das Matching beginnt, sollten Banktransaktionen unabhängig von ihrer ursprünglichen Quelle in ein einheitliches Format übertragen werden.
Wie die Bankdaten technisch abgerufen werden, sollte für den Matching Algorithmus keine Rolle spielen.
Aus diesen beiden Objekten müssen anschließend Merkmale erzeugt werden, anhand derer eine Zuordnung bewertet werden kann.
Schritt 1: Nicht jede Transaktion mit jeder Rechnung vergleichen
Angenommen, ein Unternehmen hat 80.000 Rechnungen in seiner Datenbank.
Es wäre unnötig, einen neuen Zahlungseingang mit jeder einzelnen Rechnung zu vergleichen. Stattdessen sollte zunächst eine möglichst kleine Kandidatenmenge erzeugt werden.
Für einen eingehenden Betrag in Euro könnten beispielsweise nur Rechnungen betrachtet werden, die:
noch offen sind
dieselbe Währung besitzen
zeitlich grundsätzlich zur Zahlung passen
einen plausiblen offenen Betrag besitzen
nicht storniert wurden
Aus 80.000 Rechnungen werden dadurch vielleicht noch 20 oder 50 Kandidaten.
SELECT *
FROM invoices
WHERE status = 'open'
AND currency = 'EUR'
AND invoice_date <= '2026-09-04';
Wenn die IBAN bereits einem Kunden zugeordnet werden kann, lassen sich beispielsweise zunächst nur dessen offene Rechnungen betrachten.
Banktransaktion
      |
      v
IBAN bekannt?
      |
      v
Kunde ermitteln
      |
      v
Nur offene Rechnungen
dieses Kunden betrachten
Je besser diese Vorauswahl funktioniert, desto einfacher wird der eigentliche Matching Schritt.
Schritt 2: Rechnungsnummern im Verwendungszweck erkennen
Eine Rechnungsnummer im Verwendungszweck ist normalerweise eines der stärksten Signale.
Das Problem besteht darin, dass Kunden die Nummer nicht immer exakt übernehmen.
Aus RE-2026-004402 kann beispielsweise RE 2026 004402, Rechnung: 4402 oder RG4402 werden.
Werte zuerst normalisieren
Vor dem Vergleich können beide Werte normalisiert werden.
Aus RE-2026/004402 wird beispielsweise RE2026004402.
Und aus Zahlung Rechnung RE 2026 004402 vielen Dank wird ZAHLUNGRECHNUNGRE2026004402VIELENDANK.
import re

def normalize(value):
    value = value.upper()
    return re.sub(r'[^A-Z0-9]', '', value)

invoice_number = normalize("RE-2026-004402")
reference = normalize("Zahlung RE 2026 004402")

if invoice_number in reference:
    print("Rechnungsnummer gefunden")
In der Praxis können zusätzlich alternative Schreibweisen berücksichtigt werden. Wenn die interne Rechnungsnummer RE-2026-004402 lautet, könnte auch nach dem signifikanten Bestandteil 004402 gesucht werden.
Dabei ist Vorsicht notwendig. Je kürzer eine Referenz wird, desto höher wird die Wahrscheinlichkeit eines zufälligen Treffers.
Schritt 3: Den Zahlungsbetrag bewerten
Der Betrag ist ebenfalls ein starkes Signal. Wenn eine Rechnung über 539 Euro offen ist und genau 539 Euro eingehen, spricht das für eine Zuordnung.
Aber ein nicht exakt übereinstimmender Betrag bedeutet nicht automatisch, dass die Rechnung falsch ist.
Skonto berücksichtigen
Nehmen wir eine Rechnung über 555,67 Euro mit drei Prozent Skonto.
Ein Algorithmus sollte deshalb nicht ausschließlich prüfen, ob Zahlung und Rechnungsbetrag exakt identisch sind. Er sollte auch einen gültigen Skontobetrag erkennen.
Zusätzlich sollte geprüft werden, ob der Zahlungseingang innerhalb der vereinbarten Skontofrist erfolgt ist.
Rundungsdifferenzen berücksichtigen
Auch kleine Rundungsabweichungen können vorkommen.
Wie groß eine solche Toleranz sein darf, hängt vom jeweiligen Prozess ab. Die Regel sollte deshalb konfigurierbar sein und nicht tief im Programmcode versteckt werden.
Schritt 4: Die IBAN des Zahlungspflichtigen nutzen
Wenn ein Kunde bereits früher bezahlt hat, kann seine IBAN ein sehr starkes Merkmal sein.
DE021203...
    |
    v
Kunde 4711
    |
    v
Offene Rechnungen
von Kunde 4711
Das reduziert die Kandidatenmenge erheblich.
Allerdings darf auch die IBAN nicht als alleinige Wahrheit betrachtet werden. Unternehmen besitzen mehrere Bankkonten. Konzerne bezahlen Rechnungen zentral. Zahlungen können auch von anderen Konten stammen.
Eine unbekannte IBAN bedeutet deshalb nicht automatisch, dass kein Match möglich ist. Umgekehrt ist eine bekannte IBAN ein sehr gutes zusätzliches Signal.
Schritt 5: Namen normalisieren und ähnlichkeitsbasiert vergleichen
Firmennamen sind besonders fehleranfällig.
Im ERP steht beispielsweise Müller Textil GmbH. Auf dem Kontoauszug steht MUELLER TEXTILIEN GMBH.
Ein exakter String Vergleich würde hier fehlschlagen.
Vor dem Vergleich können Namen deshalb normalisiert werden.
Groß und Kleinschreibung vereinheitlichen
Umlaute vereinheitlichen
Satzzeichen entfernen
doppelte Leerzeichen entfernen
Rechtsformen vereinheitlichen oder entfernen
häufige Zusätze ignorieren
Aus Müller Textil GmbH könnte beispielsweise MUELLER TEXTIL werden. Aus Mueller Textilien GmbH wird MUELLER TEXTILIEN.
Anschließend kann eine String Ähnlichkeit berechnet werden. Dafür gibt es verschiedene Verfahren, zum Beispiel Levenshtein Distanz oder Token basierte Ähnlichkeitsmaße.
MUELLER TEXTIL
MUELLER TEXTILIEN

Similarity: 0.91
Dieser Wert entscheidet nicht allein über die Rechnung. Er ist lediglich ein weiteres Signal.
Schritt 6: Mehrere Signale zu einem Score kombinieren
Statt mit vielen einzelnen Ja Nein Entscheidungen zu arbeiten, kann jede mögliche Zuordnung einen Score erhalten.
Rechnungsnummer exakt erkannt        +50
Betrag exakt                         +30
gültiger Skontobetrag                +25
IBAN bekannt                         +15
Name sehr ähnlich                    +10
Zahlungsdatum plausibel               +5
Für eine konkrete Zahlung könnte das Ergebnis beispielsweise so aussehen:
Rechnungsnummer erkannt              +50
gültiger Skontobetrag                +25
IBAN unbekannt                         0
Name sehr ähnlich                    +10
Zahlungsdatum plausibel               +5
-----------------------------------------
Gesamt                                90
Anschließend können Schwellenwerte definiert werden.
Score ab 80
Automatisch zuordnen

Score 50 bis 79
Zuordnung vorschlagen

Score unter 50
Nicht automatisch zuordnen
Die konkreten Zahlen sind keine allgemein gültige Empfehlung. Sie müssen anhand realer Daten und des jeweiligen Risikos angepasst werden.
Das Grundprinzip bleibt gleich: Je mehr unabhängige Signale dieselbe Rechnung bestätigen, desto höher kann die Sicherheit der Zuordnung sein.
Nicht nur den besten Kandidaten betrachten
Ein häufiger Fehler besteht darin, einfach die Rechnung mit dem höchsten Score zu wählen.
Rechnung A: Score 91
Rechnung B: Score 90
Rechnung A hat zwar den höheren Score. Die Zuordnung ist trotzdem offensichtlich nicht eindeutig.
Anders sieht es hier aus:
Rechnung A: Score 96
Rechnung B: Score 42
Neben dem absoluten Score sollte deshalb auch der Abstand zum zweitbesten Kandidaten berücksichtigt werden.
if best_score >= 80 and best_score - second_best_score >= 20:
    automatically_assign()
else:
    require_review()
Dadurch wird verhindert, dass die Anwendung bei zwei fast identischen Kandidaten willkürlich einen davon auswählt.
Teilzahlungen
Eine Rechnung muss nicht vollständig bezahlt werden.
Das Matching kann trotzdem eindeutig sein, wenn Rechnungsnummer, IBAN und Kunde passen.
Die Bewertung des Matches und die buchhalterische Behandlung der Zahlung sollten deshalb zwei getrennte Schritte sein.
Sammelzahlungen
Komplexer wird es, wenn ein Kunde mehrere Rechnungen mit einer einzigen Überweisung bezahlt.
Rechnung A       500 €
Rechnung B       400 €
Rechnung C       600 €

Überweisung    1.500 €
Hier entspricht der Zahlungseingang keiner einzelnen Rechnung. Die Summe mehrerer offener Rechnungen entspricht aber exakt dem Zahlungsbetrag.
Technisch entsteht damit ein kombinatorisches Problem. Die Anwendung muss herausfinden, welche Kombination offener Rechnungen den Zahlungsbetrag ergibt. Dieses Problem ähnelt dem bekannten Subset Sum Problem.
Bei wenigen offenen Rechnungen ist das noch einfach. Bei einem Kunden mit sehr vielen offenen Posten möchte man allerdings nicht blind jede mögliche Kombination ausprobieren.
Deshalb sollte die Kandidatenmenge auch hier zunächst eingeschränkt werden.
Rechnungen desselben Kunden
Rechnungen innerhalb eines plausiblen Zeitraums
Referenzen im Verwendungszweck
Rechnungsnummern in einer Zahlungsmitteilung
exakt passender Gesamtbetrag
Überzahlungen
Auch das Gegenteil kommt vor.
Rechnung       539,00 €
Zahlung        559,00 €
Die Software sollte nicht versuchen, die Differenz zwangsläufig durch einen anderen offenen Posten zu erklären.
Mögliche Ursachen sind Tippfehler, eine zusätzliche Rechnung, eine Vorauszahlung, ein bewusstes Guthaben oder eine falsche Zahlungsreferenz.
Eine robuste Matching Engine sollte deshalb zwischen der Frage nach der wahrscheinlichsten Rechnung und der Frage nach der korrekten Verbuchung unterscheiden.
Doppelte Transaktionen vermeiden
Banktransaktionen werden häufig regelmäßig importiert. Dabei muss verhindert werden, dass dieselbe Transaktion mehrfach verarbeitet wird.
Dafür sollte jede Transaktion möglichst eine stabile technische ID besitzen.
Beim nächsten Import wird zunächst geprüft, ob die Transaktion bereits vorhanden ist.
Falls die Bank keine ausreichend stabile ID liefert, kann alternativ ein eigener Fingerprint aus mehreren Merkmalen erzeugt werden. Dabei muss berücksichtigt werden, dass theoretisch zwei identische Zahlungen existieren können.
Was passiert bei einer Stornierung oder Rückzahlung?
Auch eine bereits verarbeitete Zahlung kann später wieder relevant werden. Beispielsweise durch Rücküberweisung, Rücklastschrift, Korrekturbuchung oder eine fehlerhafte ursprüngliche Zuordnung.
Deshalb sollte eine Zuordnung nicht einfach nur den Rechnungsstatus von open auf paid setzen.
Besser ist ein nachvollziehbares Datenmodell.
Banktransaktion
      |
      v
Payment Allocation
      |
      v
Rechnung
Die Zuordnung selbst kann als eigener Datensatz gespeichert werden.
Dadurch bleibt nachvollziehbar, warum eine Rechnung als bezahlt oder teilweise bezahlt betrachtet wurde.
Wann sollte KI eingesetzt werden?
Nicht jeder Teil des Rechnungsabgleichs benötigt künstliche Intelligenz.
Viele Informationen lassen sich zuverlässiger und nachvollziehbarer mit klassischen Regeln verarbeiten.
Eine exakte Rechnungsnummer braucht kein Sprachmodell. Ein exakter Betrag braucht kein Sprachmodell. Eine bekannte IBAN ebenfalls nicht.
Rechnungsnummer vorhanden?
          |
          v
        Regel
          |
          v
Betrag plausibel?
          |
          v
        Regel
          |
          v
IBAN bekannt?
          |
          v
        Regel
          |
          v
Name ähnlich?
          |
          v
Fuzzy Matching
          |
          v
Immer noch unklar?
          |
          v
KI oder manuelle Prüfung
KI kann interessant werden, wenn Informationen unstrukturiert oder sprachlich schwierig sind.
Beispielsweise könnte im Verwendungszweck stehen:
Ausgleich August abzgl Rekla zu Auftrag 1841
Ein Sprachmodell könnte daraus zusätzliche Hinweise ableiten. Die Entscheidung sollte trotzdem nicht allein aufgrund einer solchen Interpretation automatisiert werden.
Gerade in buchhalterischen Prozessen ist Nachvollziehbarkeit wichtig. Deshalb bietet sich eine Kombination aus deterministischen Regeln, statistischen Verfahren und optionaler KI an.
Eine einfache Matching Funktion
Ein stark vereinfachter Prototyp könnte folgendermaßen aussehen:
Anschließend wird nicht nur ein Kandidat bewertet. Alle plausiblen Kandidaten erhalten einen Score.
results = []

for invoice in candidate_invoices:
    results.append({
        "invoice": invoice,
        "score": calculate_score(transaction, invoice)
    })

results.sort(
    key=lambda result: result["score"],
    reverse=True
)
Danach kann entschieden werden, ob automatisch zugeordnet werden darf.
best = results[0]
second = results[1] if len(results) > 1 else None

if (
    best["score"] >= 80
    and (
        second is None
        or best["score"] - second["score"] >= 20
    )
):
    assign_automatically(best["invoice"])
else:
    request_manual_review()
Das ist noch keine produktionsreife Buchhaltungssoftware. Es zeigt aber das Grundprinzip gut.
Regeln sollten erklärbar bleiben
Ein großer Vorteil eines solchen Score Modells besteht darin, dass die Entscheidung nachvollziehbar bleibt.
Statt nur anzuzeigen, dass eine Rechnung automatisch zugeordnet wurde, kann die Anwendung erklären:
Zuordnung zu RE-2026-004402

Rechnungsnummer erkannt       +50
Skontobetrag erkannt          +25
Name sehr ähnlich             +10
Zahlungsdatum plausibel        +5

Gesamt                         90
Für einen Sachbearbeiter ist das wesentlich hilfreicher. Er sieht sofort, warum die Software eine bestimmte Rechnung vorgeschlagen hat.
Human in the Loop statt Automatisierung um jeden Preis
Das Ziel sollte nicht sein, jede einzelne Zahlung automatisch zuzuordnen.
Das Ziel sollte sein, möglichst viele eindeutige Fälle automatisch zu bearbeiten und die verbleibenden Fälle sinnvoll vorzubereiten.
Banktransaktion
      |
      v
Matching Engine
      |
      v
Confidence Score
      |
      + automatisch zuordnen
      + Vorschlag anzeigen
      + ungeklärt lassen
Wenn eine Zahlung offensichtlich zu einer Rechnung gehört, spart die Automatisierung manuelle Arbeit.
Wenn zwei Rechnungen praktisch gleich wahrscheinlich sind, sollte die Anwendung dagegen nicht raten.
Ein falsch automatisch zugeordneter Zahlungseingang kann mehr Aufwand verursachen als eine bewusst offengelassene Transaktion.
Ein sinnvoller Aufbau der Anwendung
Bank
 |
 v
Bank Adapter
 |
 v
Transaction Normalizer
 |
 v
Candidate Generator
 |
 v
Feature Extraction
 |
 + Rechnungsnummer
 + Betrag
 + Skonto
 + IBAN
 + Name
 + Datum
 |
 v
Scoring
 |
 v
Decision Engine
 |
 + Automatisch
 + Review
 + Ungeklärt
 |
 v
Payment Allocation
 |
 v
Rechnung
Der Bank Adapter kümmert sich nur darum, Banktransaktionen in die Anwendung zu bekommen.
Der Transaction Normalizer übersetzt die unterschiedlichen Bankdaten in ein einheitliches internes Format. Der Candidate Generator sucht passende offene Rechnungen. Die Feature Extraction berechnet die einzelnen Signale. Das Scoring bewertet jeden Kandidaten. Die Decision Engine entscheidet schließlich, ob automatisch zugeordnet werden darf oder ein Mensch den Fall prüfen sollte.
Diese Trennung hat einen weiteren Vorteil: Jeder Teil lässt sich separat testen.
Mit echten Fällen testen
Für einen Prototypen würde ich nicht nur künstlich einfache Testdaten verwenden.
Interessanter sind Fälle, die auch im tatsächlichen Zahlungsverkehr vorkommen.
exakte Rechnungsnummer und exakter Betrag
keine Rechnungsnummer, aber bekannte IBAN und passender Betrag
Rechnungsnummer vorhanden und Skonto korrekt abgezogen
Betrag passt zu zwei Rechnungen und weitere Informationen fehlen
Name leicht unterschiedlich, Betrag und Rechnungsnummer stimmen
Teilzahlung
Sammelzahlung für mehrere Rechnungen
unbekannter Absender, kein Verwendungszweck und mehrere mögliche Rechnungen
Gerade der letzte Fall ist wichtig.
Eine gute Matching Engine zeichnet sich nicht nur dadurch aus, dass sie richtige Zuordnungen findet. Sie sollte auch erkennen, wann die vorhandenen Informationen für eine sichere Entscheidung nicht ausreichen.
Fazit
Ein automatischer Rechnungsabgleich ist weniger ein einzelner Algorithmus als eine Kombination mehrerer kleiner Entscheidungen.
Rechnungsnummer, Betrag, Skonto, IBAN, Name und Zahlungsdatum liefern jeweils Hinweise. Keines dieser Merkmale ist für sich allein immer zuverlässig. Zusammen ergeben sie allerdings ein starkes Signal.
Eine robuste Lösung erzeugt deshalb zunächst eine kleine Menge plausibler Rechnungen, bewertet anschließend mehrere Merkmale und berechnet daraus eine Sicherheit für jede mögliche Zuordnung.
Eindeutige Fälle können automatisch verarbeitet werden. Unsichere Fälle werden als Vorschlag angezeigt oder bleiben bewusst ungeklärt.
Wenn Sie den automatischen Abgleich von Bankumsätzen und offenen Posten testen möchten und noch nicht wissen, wie viel sich mit Regeln, Fuzzy Matching oder KI zuverlässig automatisieren lässt, ist ein kleiner Prototyp meist der sinnvollste erste Schritt.
In 15 Minuten lässt sich unverbindlich klären, welche Matching Logik zu Ihren Daten, Sonderfällen und bestehenden Systemen passt. Zum Erstgespräch.
Bankumsätze per API abrufen: PSD2, FinTS oder EBICS?
Wer Zahlungseingänge automatisch mit offenen Rechnungen abgleichen möchte, benötigt zunächst Zugriff auf die Kontoumsätze. Was im Onlinebanking selbstverständlich aussieht, ist in einer eigenen Anwendung allerdings nicht ganz so trivial.
In Deutschland gibt es dafür mehrere Wege. Relevant sind vor allem PSD2 beziehungsweise Open Banking, FinTS und EBICS. Welche Schnittstelle sinnvoll ist, hängt stark vom Anwendungsfall ab.
Für einen Prototypen mit einem eigenen Konto gelten andere Anforderungen als für eine produktive Anbindung eines Firmenkontos. Noch einmal anders sieht es aus, wenn Kunden einer Software ihre eigenen Bankkonten verbinden sollen.
Welche Daten werden für den Rechnungsabgleich benötigt?
Für einen automatischen Zahlungsabgleich werden zunächst keine besonders exotischen Bankdaten benötigt. Ein typischer Zahlungseingang könnte intern beispielsweise so aussehen:
Aus diesen Informationen kann eine Anwendung anschließend versuchen, einen passenden offenen Posten zu finden.
Die eigentliche Matching Logik sollte dabei nicht davon abhängen, über welche Bankschnittstelle die Daten geliefert wurden. Ob eine Transaktion ursprünglich aus einer CSV Datei, über FinTS, über PSD2 oder aus einer EBICS Datei gekommen ist, sollte für die spätere Verarbeitung keine Rolle spielen.
CSV
FinTS
PSD2
EBICS
  |
  v
Bank Adapter
  |
  v
Normalisierte Transaktion
  |
  v
Matching Engine
  |
  v
Offene Rechnung
Damit lässt sich die Bankanbindung später austauschen, ohne die eigentliche Logik des Rechnungsabgleichs neu entwickeln zu müssen.
Möglichkeit 1: PSD2 und Open Banking
PSD2 bildet in Europa den rechtlichen Rahmen dafür, dass regulierte Drittanbieter auf Zahlungskonten zugreifen können. In der Praxis begegnet man dabei häufig dem Begriff Open Banking oder XS2A.
Vereinfacht sieht der Zugriff so aus:
Eigene Anwendung
      |
      v
Open Banking Schnittstelle
      |
      v
Bank
      |
      v
Konten und Transaktionen
Auf den ersten Blick klingt das nach einer gewöhnlichen REST API. In der Praxis gehören aber Zustimmung des Kontoinhabers, Authentifizierung und bankabhängige Abläufe dazu.
PSD2 ist keine einfache API mit dauerhaftem API Key
Bei vielen Web APIs hinterlegt eine Anwendung einmal Zugangsdaten und ruft anschließend dauerhaft Daten ab. Beim Zugriff auf Bankkonten ist das bewusst anders.
Der Kontoinhaber muss den Zugriff autorisieren. Je nach Verfahren und Bank sind dabei Schritte zur starken Kundenauthentifizierung erforderlich. Für eine Anwendung, die Konten vieler Nutzer anbinden soll, entsteht dadurch deutlich mehr Integrationsaufwand als bei einer klassischen Unternehmens API.
Deshalb werden häufig spezialisierte Open Banking Anbieter eingesetzt. Sie bündeln unterschiedliche Banken hinter einer einheitlicheren Schnittstelle.
Eigene Anwendung
      |
      v
Open Banking Anbieter
      |
      + Bank A
      + Bank B
      + Bank C
Für ein SaaS Produkt kann dieser Ansatz besonders interessant sein, weil nicht jede einzelne Bank separat integriert werden muss.
Wenn eine Anwendung Kontoinformationen fremder Nutzer verarbeitet, sollte neben der technischen Umsetzung auch die regulatorische Einordnung geprüft werden. Für einen internen Prototypen mit dem eigenen Konto ist die Ausgangslage eine andere als für einen Dienst, der Bankkonten von Kunden verbindet.
Wann ist PSD2 sinnvoll?
PSD2 beziehungsweise Open Banking ist vor allem interessant, wenn Nutzer einer Anwendung ihre eigenen Bankkonten verbinden sollen.
Finanz Apps
Buchhaltungssoftware
Liquiditätsplanung
Multibanking Anwendungen
SaaS Lösungen mit vielen unterschiedlichen Kundenkonten
Für ein einzelnes eigenes Firmenkonto gibt es dagegen häufig einen anderen etablierten Weg.
Möglichkeit 2: FinTS
FinTS steht für Financial Transaction Services und ist der Nachfolger von HBCI. Das Verfahren wird in Deutschland seit vielen Jahren von Banking Software genutzt, um mit Kreditinstituten zu kommunizieren.
Je nach Bank und unterstütztem Geschäftsvorfall lassen sich darüber unter anderem Kontoinformationen abrufen.
FinTS ist deshalb für Entwickler interessant, die zunächst mit einem eigenen deutschen Bankkonto experimentieren möchten.
Privatkonto
    |
    v
FinTS
    |
    v
Eigene Anwendung
    |
    v
Transaktionen
FinTS sollte allerdings nicht mit einer modernen REST API verwechselt werden. Das Protokoll bringt eine eigene Dialoglogik, Bankparameter und Sicherheitsverfahren mit.
Für FinTS Softwareprodukte gibt es außerdem Anforderungen an die Produktregistrierung. Wer FinTS nicht nur zum Experimentieren, sondern als Bestandteil eines eigenen Produkts einsetzen möchte, sollte diese frühzeitig prüfen.
In vielen Programmiersprachen existieren bereits Bibliotheken, die Teile des Protokolls abstrahieren. Für einen Prototypen ist das in der Regel sinnvoller, als FinTS selbst vollständig zu implementieren.
Wann ist FinTS sinnvoll?
FinTS kann interessant sein, wenn eine Anwendung auf deutsche Bankkonten zugreifen soll und der Banking Zugriff selbst kontrolliert werden soll.
Für einen Prototypen mit einem eigenen Konto kann es ebenfalls eine praktische Option sein. Ob daraus später die richtige Architektur für eine produktive Anwendung wird, sollte getrennt entschieden werden.
Möglichkeit 3: EBICS
EBICS steht für Electronic Banking Internet Communication Standard. Während PSD2 stark mit dem Zugriff durch Drittanbieter verbunden ist und FinTS aus dem klassischen Onlinebanking Umfeld stammt, ist EBICS vor allem im Firmenkundengeschäft relevant.
Unternehmen nutzen EBICS für den automatisierten Datenaustausch zwischen eigenen Systemen und Banken.
ERP oder eigene Anwendung
          |
          v
        EBICS
          |
          v
         Bank
Der große Vorteil liegt im automatisierten Austausch. EBICS passt deshalb gut zu Anwendungen in Buchhaltung, Treasury oder Zahlungsverkehr.
Kontoauszüge über camt.053
EBICS beschreibt den Kommunikationsweg mit der Bank. Die eigentlichen Kontoinformationen werden in entsprechenden Datenformaten übertragen.
Für elektronische Kontoinformationen spielen heute insbesondere die ISO 20022 Formate der camt Familie eine Rolle. Für gebuchte Kontoumsätze ist camt.053 besonders relevant. camt.052 wird für untertägige Kontoinformationen verwendet.
Bank
 |
 v
EBICS
 |
 v
camt.053
 |
 v
XML Parser
 |
 v
Transaktionen
 |
 v
Rechnungsabgleich
Eine camt Datei enthält nicht nur Beträge und Buchungsdaten. Je nach Zahlung und Bank können auch Namen, Kontoinformationen, Referenzen und Verwendungszwecke enthalten sein.
Diese Informationen werden aus dem XML Format extrahiert und anschließend in das interne Transaktionsmodell der Anwendung übertragen.
Ist EBICS eine REST API?
Nein.
Wer aus der klassischen Webentwicklung kommt, erwartet häufig einen Ablauf wie:
GET /transactions
und als Antwort ein JSON Dokument.
EBICS funktioniert anders. Das Protokoll besitzt eigene Abläufe für Authentifizierung, Schlüssel und den Austausch von Daten mit dem Kreditinstitut.
Deshalb ist die Integration zunächst aufwendiger als die Verwendung einer gewöhnlichen REST API. Technisch lässt sich dieser Teil aber sauber kapseln.
Eigene Anwendung
      |
      v
EBICS Adapter
      |
      v
EBICS Kommunikation
      |
      v
Bank
Die restliche Anwendung arbeitet dann weiterhin nur mit einem einfachen internen Datenmodell.
Wann ist EBICS sinnvoll?
EBICS ist besonders interessant, wenn eigene Firmenkonten dauerhaft in automatisierte Unternehmensprozesse eingebunden werden sollen.
automatischer Abruf von Kontoauszügen
Zahlungsverkehr aus ERP Systemen
Treasury Systeme
Debitorenbuchhaltung
automatischer Rechnungsabgleich
Anbindung mehrerer Firmenkonten
Für ein privates Testkonto ist EBICS dagegen normalerweise nicht der erste Weg.
PSD2, FinTS und EBICS im Vergleich
Anwendungsfall
Typischer Ansatz
Erster Prototyp ohne echte Bankintegration
CSV oder exportierter Kontoauszug
Prototyp mit eigenem Privatkonto
FinTS oder Open Banking
Eigenes Firmenkonto
EBICS prüfen
Mehrere eigene Firmenkonten
EBICS
Kunden sollen ihre Konten verbinden
PSD2 beziehungsweise Open Banking Anbieter
Buchhaltungsintegration im Unternehmen
häufig EBICS
Auch technisch unterscheiden sich die Ansätze deutlich.
Eigenschaft
PSD2 / Open Banking
FinTS
EBICS
Typisches Umfeld
Drittanbieter und Finanz Apps
Onlinebanking und Banking Software
Firmenkundengeschäft
Privatkonten
gut geeignet
häufig geeignet
normalerweise nicht relevant
Firmenkonten
möglich
möglich
sehr relevant
Viele fremde Konten
gut geeignet
eher aufwendig
nicht der typische Anwendungsfall
Automatisierte Unternehmensprozesse
möglich
möglich
sehr gut geeignet
Integration
API orientiert
eigenes Protokoll
eigenes Protokoll und Dateiformate
Die Tabelle ist bewusst vereinfacht. Welche Funktionen tatsächlich verfügbar sind, hängt bei allen Varianten auch von der jeweiligen Bank und dem konkreten Zugang ab.
Wie würde ich einen Prototypen aufbauen?
Für einen ersten Prototypen eines automatischen Rechnungsabgleichs würde ich die Bankintegration nicht an den Anfang stellen.
Die interessante Frage lautet zunächst: Kann die Anwendung Banktransaktionen zuverlässig mit offenen Rechnungen abgleichen?
Dafür reicht am Anfang ein exportierter Kontoauszug.
CSV Datei
   |
   v
Importer
   |
   v
Transaktionen
   |
   v
Matching Engine
   |
   v
Offene Rechnungen
Der Importer überführt die Daten in ein neutrales Format. Auf diesem Datenmodell kann anschließend die eigentliche Matching Logik entwickelt werden.
Erst wenn diese funktioniert, wird der CSV Import durch eine echte Bankanbindung ersetzt.
FinTS
PSD2
EBICS
  |
  v
Bank Adapter
  |
  v
Transaktionen
  |
  v
Matching Engine
Dieser Aufbau trennt zwei unterschiedliche Probleme voneinander.
Das erste Problem ist der Zugriff auf die Bankdaten.
Das zweite Problem ist die intelligente Zuordnung dieser Bankdaten zu offenen Rechnungen.
Beide Aufgaben können dadurch unabhängig entwickelt und getestet werden.
Und wie wird aus einer Banktransaktion die richtige Rechnung?
Sobald die Transaktionen vorliegen, beginnt der eigentlich interessante Teil.
Eine Zahlung über 539 Euro könnte beispielsweise den Verwendungszweck RG 4402 enthalten. Im ERP existiert gleichzeitig eine offene Rechnung über 555,67 Euro mit drei Prozent Skonto. Der Auftraggeber heißt auf dem Kontoauszug Mueller Textilien GmbH, während der Kunde im ERP als Müller Textil gespeichert ist.
Ein einfacher Vergleich des Betrags reicht hier nicht aus.
Eine Matching Engine kann deshalb mehrere Informationen gleichzeitig berücksichtigen:
Rechnungsnummer
Zahlungsbetrag
mögliche Skontoabzüge
IBAN
Name des Zahlungspflichtigen
Buchungsdatum
offene Rechnungen des betreffenden Kunden
Aus diesen Signalen lässt sich anschließend bewerten, wie wahrscheinlich eine bestimmte Zuordnung ist.
Wer Zahlungseingänge automatisiert verarbeiten möchte, braucht zunächst einen zuverlässigen Weg vom Bankkonto in die eigene Anwendung.
Dafür gibt es nicht die eine richtige Banking API.
PSD2 und Open Banking sind besonders interessant, wenn Nutzer ihre eigenen Konten mit einer Anwendung verbinden sollen. FinTS kann für deutsche Konten und eigene Integrationen relevant sein. EBICS ist dagegen vor allem für automatisierte Prozesse mit Firmenkonten interessant.
Für einen Prototypen muss die Bankintegration trotzdem nicht der erste Schritt sein. Oft ist es sinnvoller, zunächst einige reale oder anonymisierte Kontoumsätze zu importieren und daraus ein einheitliches Datenmodell zu erstellen. Sobald der Rechnungsabgleich darauf zuverlässig funktioniert, kann die Datenquelle durch FinTS, PSD2 oder EBICS ersetzt werden.
Die Bankschnittstelle liefert die Daten. Die eigentliche Automatisierung entsteht erst bei der Frage, was anschließend mit diesen Daten passiert.
Wenn Sie Bankumsätze automatisiert in eigene Anwendungen oder Finanzprozesse integrieren möchten und noch nicht wissen, ob PSD2, FinTS oder EBICS zu Ihrer Systemlandschaft passt, ist ein kleiner Prototyp meist der sinnvollste erste Schritt.
In 15 Minuten lässt sich unverbindlich klären, welche Architektur zu Ihren Konten, Daten und Schnittstellen passt. Zum Erstgespräch.
n8n kostenlos lokal installieren: Docker, Ollama und eigenes LLM ohne Cloud
n8n lässt sich lokal mit der selbst gehosteten Community Edition ohne Lizenzgebühr betreiben. Mit Docker starten Sie n8n auf Windows, Linux oder macOS. Optional können Sie Ollama auf dem Host installieren und ein lokales Sprachmodell wie Qwen 2.5 14B anbinden. Damit lassen sich KI Funktionen in eigenen Workflows nutzen, ohne für das Modell eine nutzungsabhängige API Rechnung zu bezahlen.
„Kostenlos“ bedeutet dabei nicht, dass keine Kosten entstehen. Die Community Edition verursacht keine Lizenzgebühr für den beschriebenen Self Hosting Betrieb. Hardware, Strom, Administration, Backups und gegebenenfalls kostenpflichtige externe Dienste bleiben davon unberührt. Ebenso gelten für n8n je nach Einsatzszenario eigene Lizenzbedingungen. Prüfen Sie deshalb vor einem produktiven Einsatz die aktuellen Lizenzbedingungen von n8n.
Diese Anleitung zeigt zunächst die technische Basis: Docker starten, n8n installieren, den Owner Account einrichten und einen ersten Workflow ausführen. Erst danach geht es optional um Ollama und den AI Assistant. So können Sie n8n zunächst als Automatisierungsplattform testen, ohne die zusätzliche KI Konfiguration zu benötigen.
Die Screenshots stammen von einem Mac. Die Docker Konfiguration ist für Windows, Linux und macOS ausgelegt. Unterschiede gibt es vor allem bei Docker Desktop, dem Zugriff auf Ollama und einzelnen Browser Eigenheiten.
Die Anleitung richtet sich an IT Verantwortliche, technische Geschäftsführungen, Entwickler und Unternehmen, die n8n zunächst selbst testen möchten. Sie ist keine Produktionsanleitung für einen öffentlich erreichbaren n8n Server. Die verwendete Compose Datei ist ausdrücklich als Development und Test Konfiguration gedacht.
Getesteter Stand: n8n 2.36.7, Ollama 0.32.15, Docker 29.6.2, Modell Qwen 2.5:14B. Bei späteren Versionen können Bezeichnungen, Menüs und einzelne Einstellungen abweichen.
Was bedeutet n8n kostenlos lokal installieren?
n8n ist eine Workflow Plattform. Sie verbinden Trigger, APIs, Dateien, Datenbanken und bei Bedarf ein Sprachmodell zu automatisierten Abläufen.
Wenn Sie n8n kostenlos lokal installieren, bedeutet das in diesem Artikel konkret:
Sie verwenden eine selbst gehostete n8n Edition, für die im beschriebenen Setup keine Lizenzgebühr anfällt.
n8n läuft auf Ihrem eigenen Rechner oder einem von Ihnen betriebenen Server.
Die Daten der n8n Instanz werden in einem lokalen Docker Volume gespeichert.
Sie können Ollama zusätzlich auf dem Host betreiben und ein lokales Sprachmodell anbinden.
Das unterscheidet sich von n8n Cloud. Dort übernimmt n8n den Betrieb der Plattform. Beim Self Hosting kümmern Sie sich selbst um Installation, Updates, Backups, Zugriffsschutz und Verfügbarkeit.
Auch die Aussage „lokal“ sollte technisch nicht mit „automatisch datenschutzkonform“ verwechselt werden. Bei einer korrekt konfigurierten lokalen Installation werden Daten nicht automatisch an n8n Cloud oder einen externen LLM Anbieter übertragen. Welche Daten Ihr System tatsächlich verlassen, hängt jedoch von den verwendeten Workflows, Integrationen, Webhooks, APIs und Modellanbietern ab.
Wenn ein Workflow beispielsweise eine externe CRM API aufruft oder ein Cloud Modell verwendet, verlassen die dafür übertragenen Daten selbstverständlich Ihr lokales System.
Am Ende der Basisinstallation haben Sie eine laufende n8n Instanz unter http://localhost:5678 und einen funktionierenden ersten Workflow. Ollama und der AI Assistant sind dafür nicht erforderlich.
n8n Cloud oder selbst hosten?
Beide Varianten haben ihre Berechtigung. Die entscheidende Frage ist, ob Sie den technischen Betrieb selbst übernehmen möchten.
n8n Cloud
Self Hosted
Kostenmodell
Abo nach aktuellem Tarif
Keine Lizenzgebühr für die entsprechende selbst gehostete Edition, eigene Betriebskosten
Betrieb
n8n übernimmt die Plattform
Sie betreiben Docker, Updates und Backups selbst
Datenhaltung
Infrastruktur des Anbieters
Ihre eigene Infrastruktur
Einrichtung
Account und fertige Umgebung
Docker und eigene Konfiguration
Lokales LLM
Externe APIs oder eigene Anbindung je nach Architektur
Ollama kann direkt im eigenen Netz betrieben werden
Geeignet für
Schneller Start ohne Plattformbetrieb
Eigene Infrastruktur und technische Kontrolle
Wann lohnt sich Self Hosting?
Self Hosting ist besonders interessant, wenn Sie Workflows zunächst intern testen, bestehende Systeme anbinden oder ein lokales Sprachmodell einsetzen möchten.
Credentials und Workflow Daten sollen in der eigenen Infrastruktur bleiben.
Sie möchten lokale Modelle ohne nutzungsabhängige LLM API Kosten testen.
IT kann Docker und die zugehörige Infrastruktur betreiben.
Sie möchten einen Prototyp später auf einen eigenen Linux Server übertragen.
Cloud ist dagegen attraktiv, wenn Sie den technischen Betrieb auslagern möchten und schnell eine fertige Umgebung benötigen.
5 Minuten Schnellstart
Der schnellste Weg zur laufenden n8n Instanz
Docker Desktop installieren und starten.
Einen leeren Ordner für n8n anlegen.
Die Compose Datei aus dem nächsten Abschnitt als docker-compose.yml speichern.
docker compose up -d ausführen.
http://localhost:5678 im Browser öffnen und den Owner Account anlegen.
Danach ist die n8n Basisinstallation fertig. Einen ersten funktionierenden Workflow bauen Sie im entsprechenden Abschnitt weiter unten. Ollama und der AI Assistant sind optionale Erweiterungen.
Warum Docker für Windows, Linux und Mac?
Docker macht die Installation von n8n weitgehend unabhängig vom Betriebssystem. Statt Node.js, Abhängigkeiten und Pfade direkt auf dem Rechner einzurichten, starten Sie ein fertiges n8n Image.
Die Compose Datei kann deshalb auf macOS, Windows mit Docker Desktop und Linux verwendet werden. Unterschiede entstehen hauptsächlich beim Zugriff auf Dienste, die außerhalb des Containers laufen.
Windows
macOS
Linux
Docker
Docker Desktop
Docker Desktop
Docker Engine plus Compose
Ollama
Host
Host
Host oder eigene Infrastruktur
Host URL aus Container
host.docker.internal
host.docker.internal
mit extra_hosts
Compose Datei
identisch
identisch
identisch
Unter Windows mit WSL2 können zusätzliche Netzwerkdetails relevant werden. Prüfen Sie bei Problemen zuerst, ob der Dienst vom Host aus erreichbar ist, bevor Sie die n8n Konfiguration ändern.
Architektur: n8n im Container, Ollama optional auf dem Host
Ihr Rechner
Optional läuft Ollama auf Port 11434. Ein lokales Modell wie qwen2.5:14b wird dort ausgeführt.
http://host.docker.internal:11434/v1
Docker
n8n läuft im Container und stellt die Weboberfläche unter Port 5678 bereit. Die n8n Daten liegen im Volume n8n_data.
Wichtig: localhost im n8n Container bezeichnet den Container selbst. Es ist nicht automatisch Ihr Host Rechner.
Was Sie brauchen
Docker Desktop unter Windows oder macOS oder Docker Engine plus Compose unter Linux
einen leeren Ordner für die Compose Datei
einen Browser
optional Ollama mit einem lokalen Modell
Für die reine n8n Installation benötigen Sie kein leistungsfähiges System. Erst das lokale Sprachmodell verändert die Hardwareanforderungen deutlich.
Vorhaben
Richtwert
Nur n8n
8 GB RAM sind für einen Test häufig ausreichend
n8n plus kleines lokales Modell
16 GB RAM
n8n plus Qwen 2.5 14B
16 GB Minimum, 32 GB angenehmer
Die konkreten Anforderungen hängen vom Modell, der Quantisierung, der Hardware und der parallelen Nutzung ab. GPU Beschleunigung betrifft vor allem die Ausführung des Modells. n8n selbst benötigt keine GPU.
n8n mit Docker Compose installieren
Wichtig: Die folgende Compose Datei ist eine Development und Test Konfiguration. Sie ist bewusst minimal gehalten und nicht als vollständige Produktionskonfiguration gedacht. Für einen produktiven Betrieb müssen unter anderem HTTPS, Zugriffsschutz, Backups, Monitoring, Secrets Management und ein definierter Update Prozess berücksichtigt werden.
Speichern Sie die Datei als docker-compose.yml in einem leeren Ordner.
N8N_SECURE_COOKIE=false ist hier für den lokalen HTTP Test gesetzt. Für einen produktiven Betrieb mit HTTPS sollte die Konfiguration entsprechend angepasst werden.
extra_hosts stellt sicher, dass host.docker.internal auch auf Linux auf den Docker Host zeigen kann. Das ist vor allem dann relevant, wenn später Ollama auf dem Host läuft.
Terminal
~/Projects/n8n docker compose up -d
[+] Running 4/4
✔ Network n8n_default Created
✔ Volume n8n_n8n_data Created
✔ Image docker.n8n.io/n8nio/n8n Pulled
✔ Container n8n-n8n-1 Started
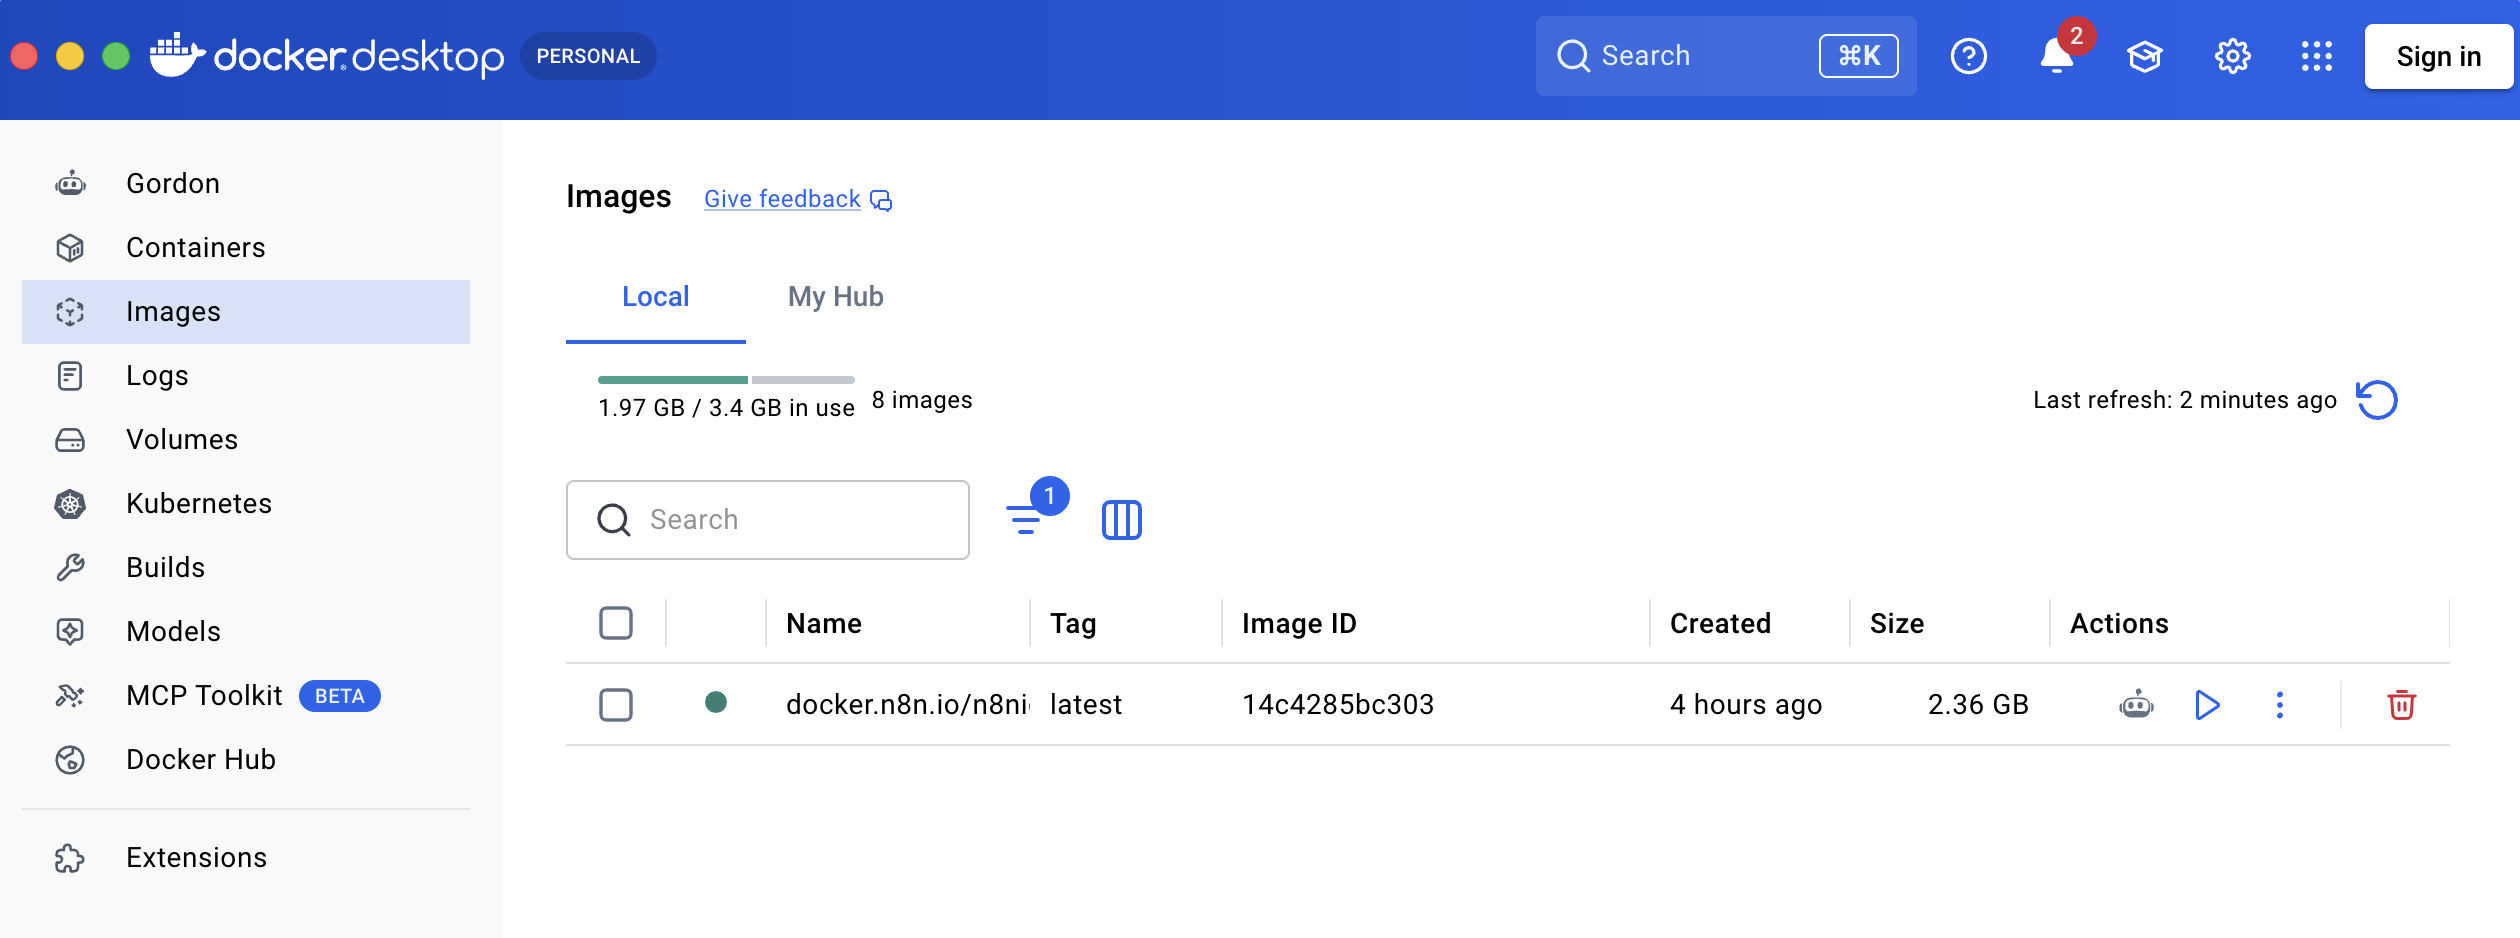
Docker erstellt Netzwerk, Volume und n8n Container.In Docker Desktop unter Images liegt das lokale Image docker.n8n.io/n8nio/n8n.
Prüfen Sie den laufenden Container mit:
docker compose ps
Die Oberfläche erreichen Sie anschließend unter:
http://localhost:5678
Zum Stoppen können Sie den Container anhalten:
docker compose stop
Zum erneuten Starten:
docker compose start
docker compose down entfernt Container und Netzwerk. Das Volume bleibt ohne -v erhalten. docker compose down -v löscht dagegen auch das Volume und damit die darin gespeicherten n8n Daten.
Für ein Update können Sie das Image neu laden und den Container neu erstellen:
docker compose pull
docker compose up -d
Vor größeren Updates sollten Sie das Datenvolume sichern.
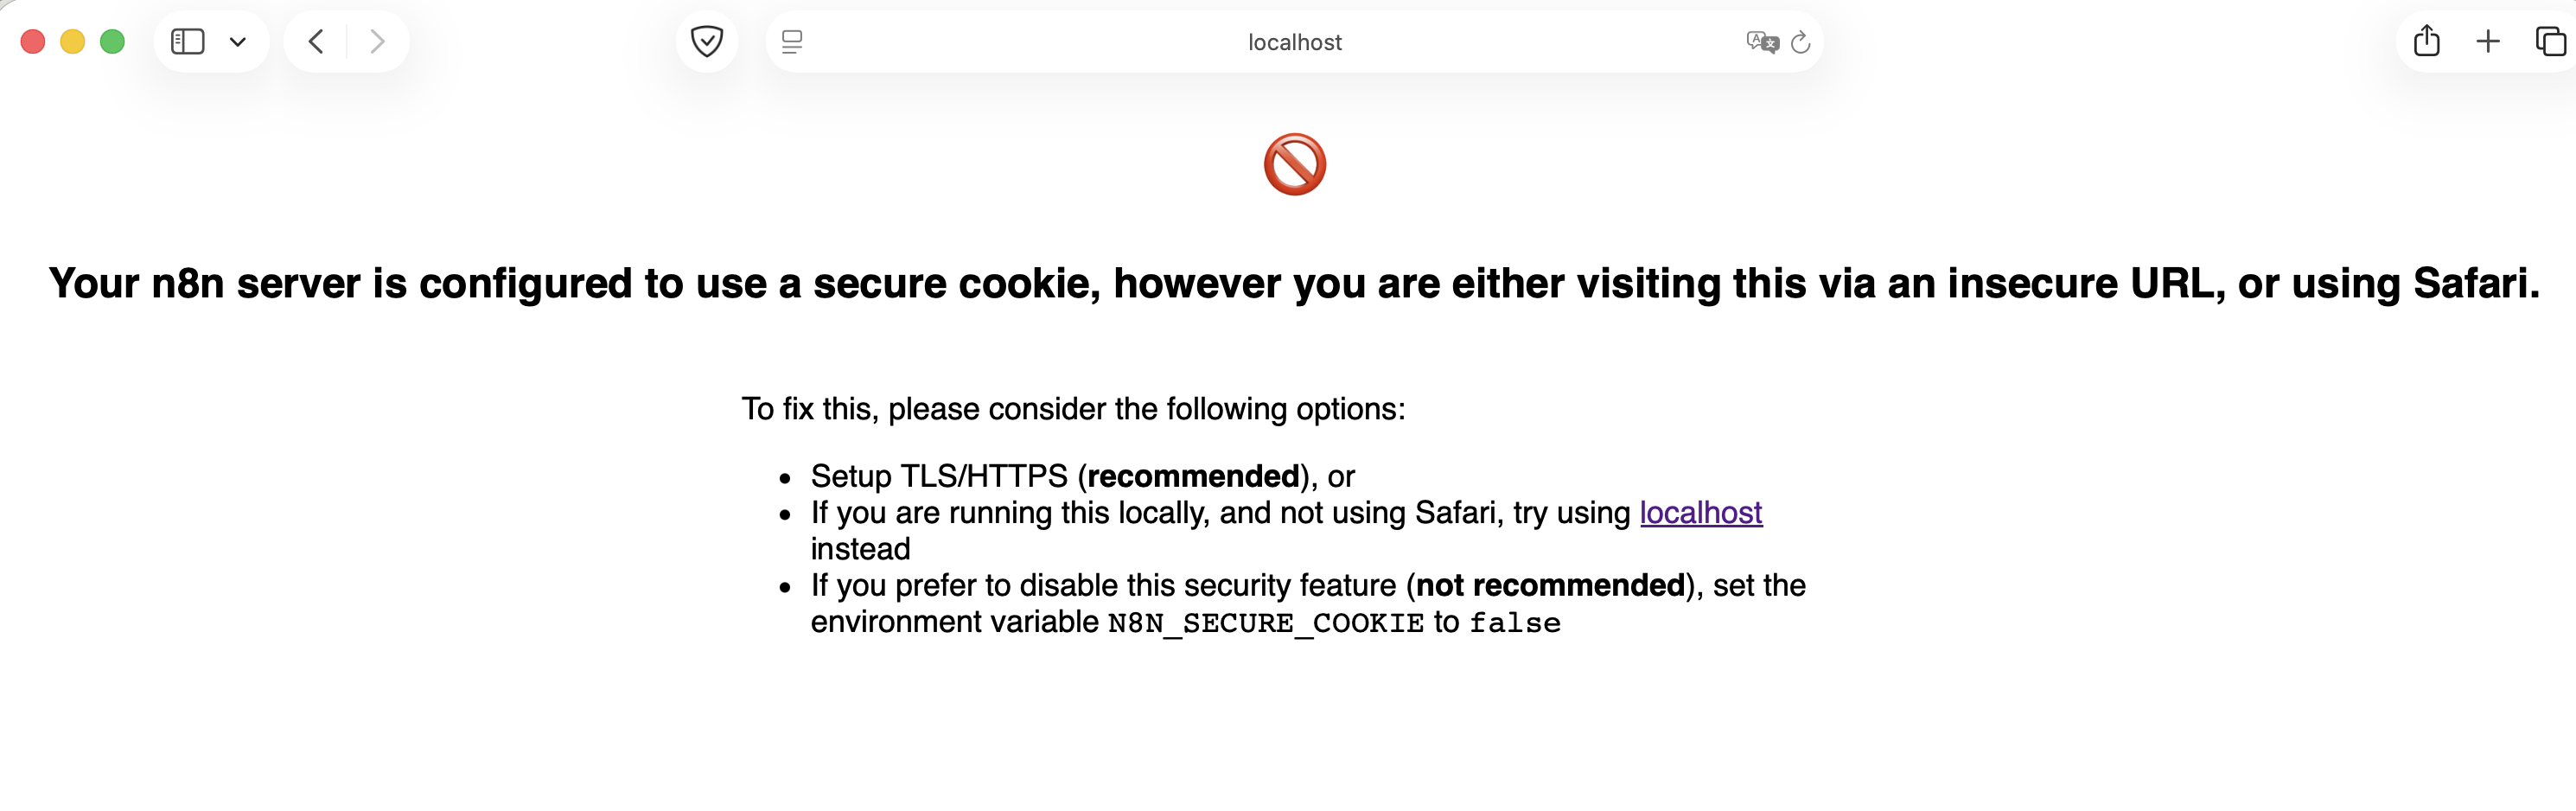
Safari und Secure Cookie
Bei einer lokalen Installation über HTTP kann Safari die n8n Oberfläche mit einem Hinweis auf Secure Cookies blockieren.
Safari unter HTTP: Der Server erwartet ein sicheres Cookie. Abhilfe ist N8N_SECURE_COOKIE=false oder ein anderer Browser.
Für den beschriebenen Development und Test Betrieb ist deshalb N8N_SECURE_COOKIE=false gesetzt. Alternativ können Sie für den lokalen Test einen anderen Browser verwenden.
Für eine produktive Umgebung sollten Sie n8n nicht einfach dauerhaft über unverschlüsseltes HTTP betreiben. Dort gehört HTTPS mit einem passenden Reverse Proxy zur Architektur.
Owner Account anlegen
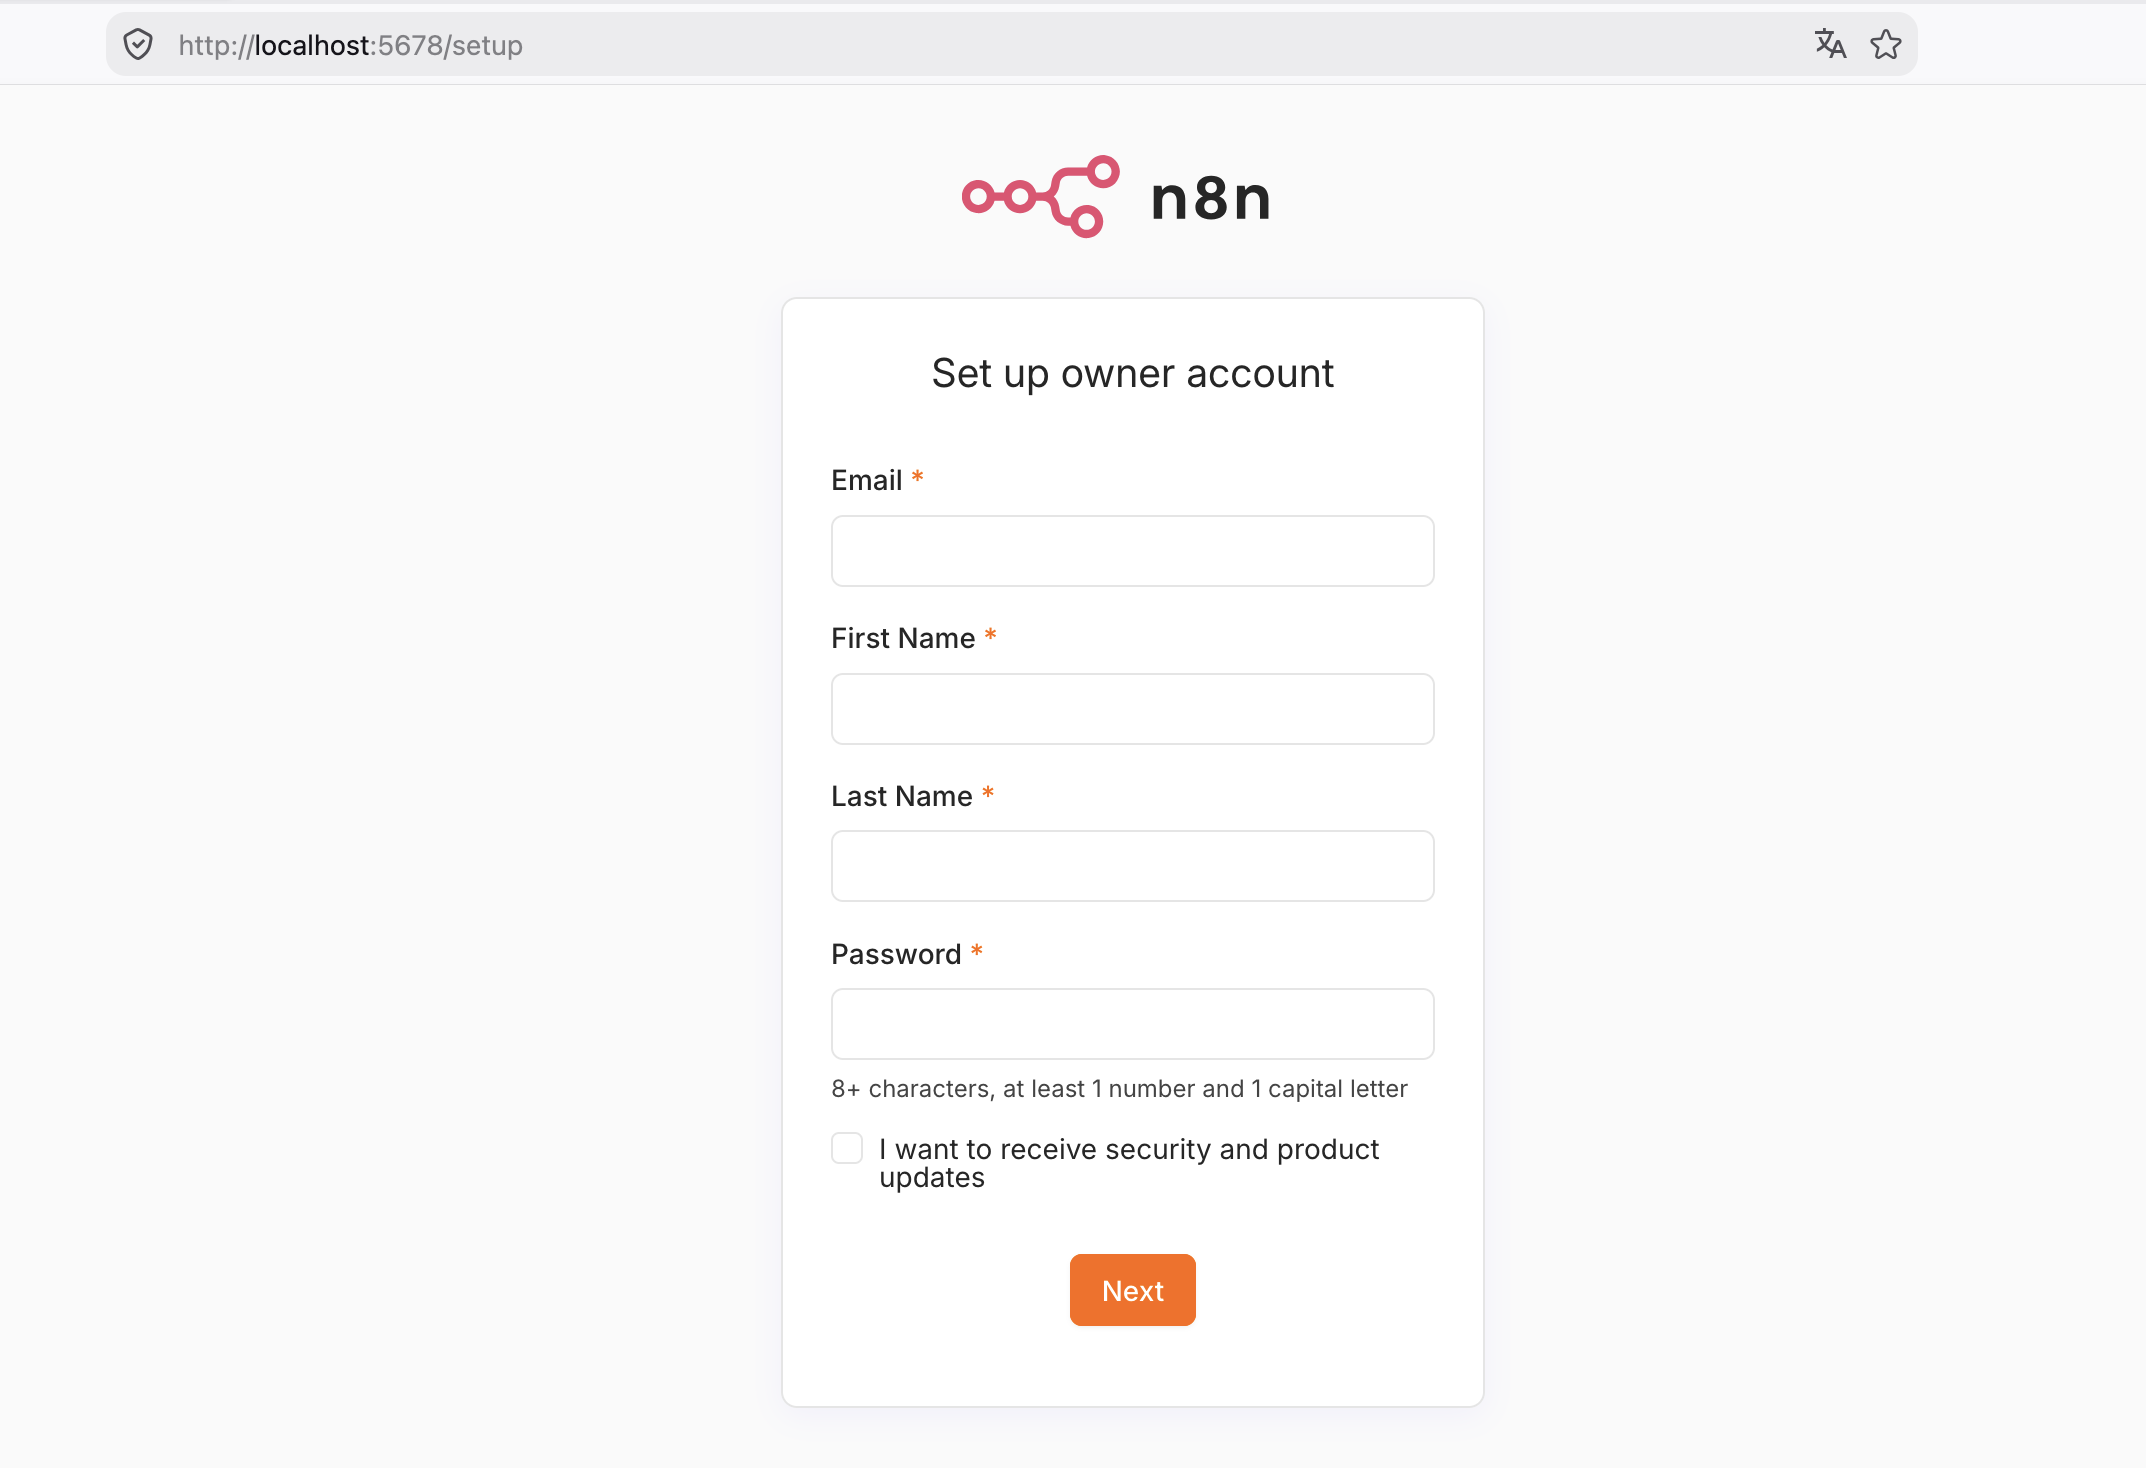
Beim ersten Aufruf von n8n legen Sie den Owner Account an.
Erstes Formular nach dem Start: E-Mail, Vorname, Nachname und Passwort. Button Next.
Danach ist die n8n Basisinstallation abgeschlossen. Ab diesem Punkt können Sie normale Workflows erstellen. Dafür benötigen Sie weder Ollama noch ein Sprachmodell noch den AI Assistant.
Das Passwort schützt die n8n Instanz. Sobald Sie den Dienst über das lokale System hinaus erreichbar machen, müssen Sie Zugriffsschutz, Netzwerk und HTTPS entsprechend absichern.
Der erste Workflow
Der erste Test sollte möglichst wenig Komplexität enthalten. Ein Manual Trigger plus HTTP Request reicht aus, um zu prüfen, ob der Container läuft und ausgehende HTTP Verbindungen funktionieren.
Erstellen Sie einen neuen Workflow und fügen Sie einen Manual Trigger sowie einen HTTP Request Node hinzu.
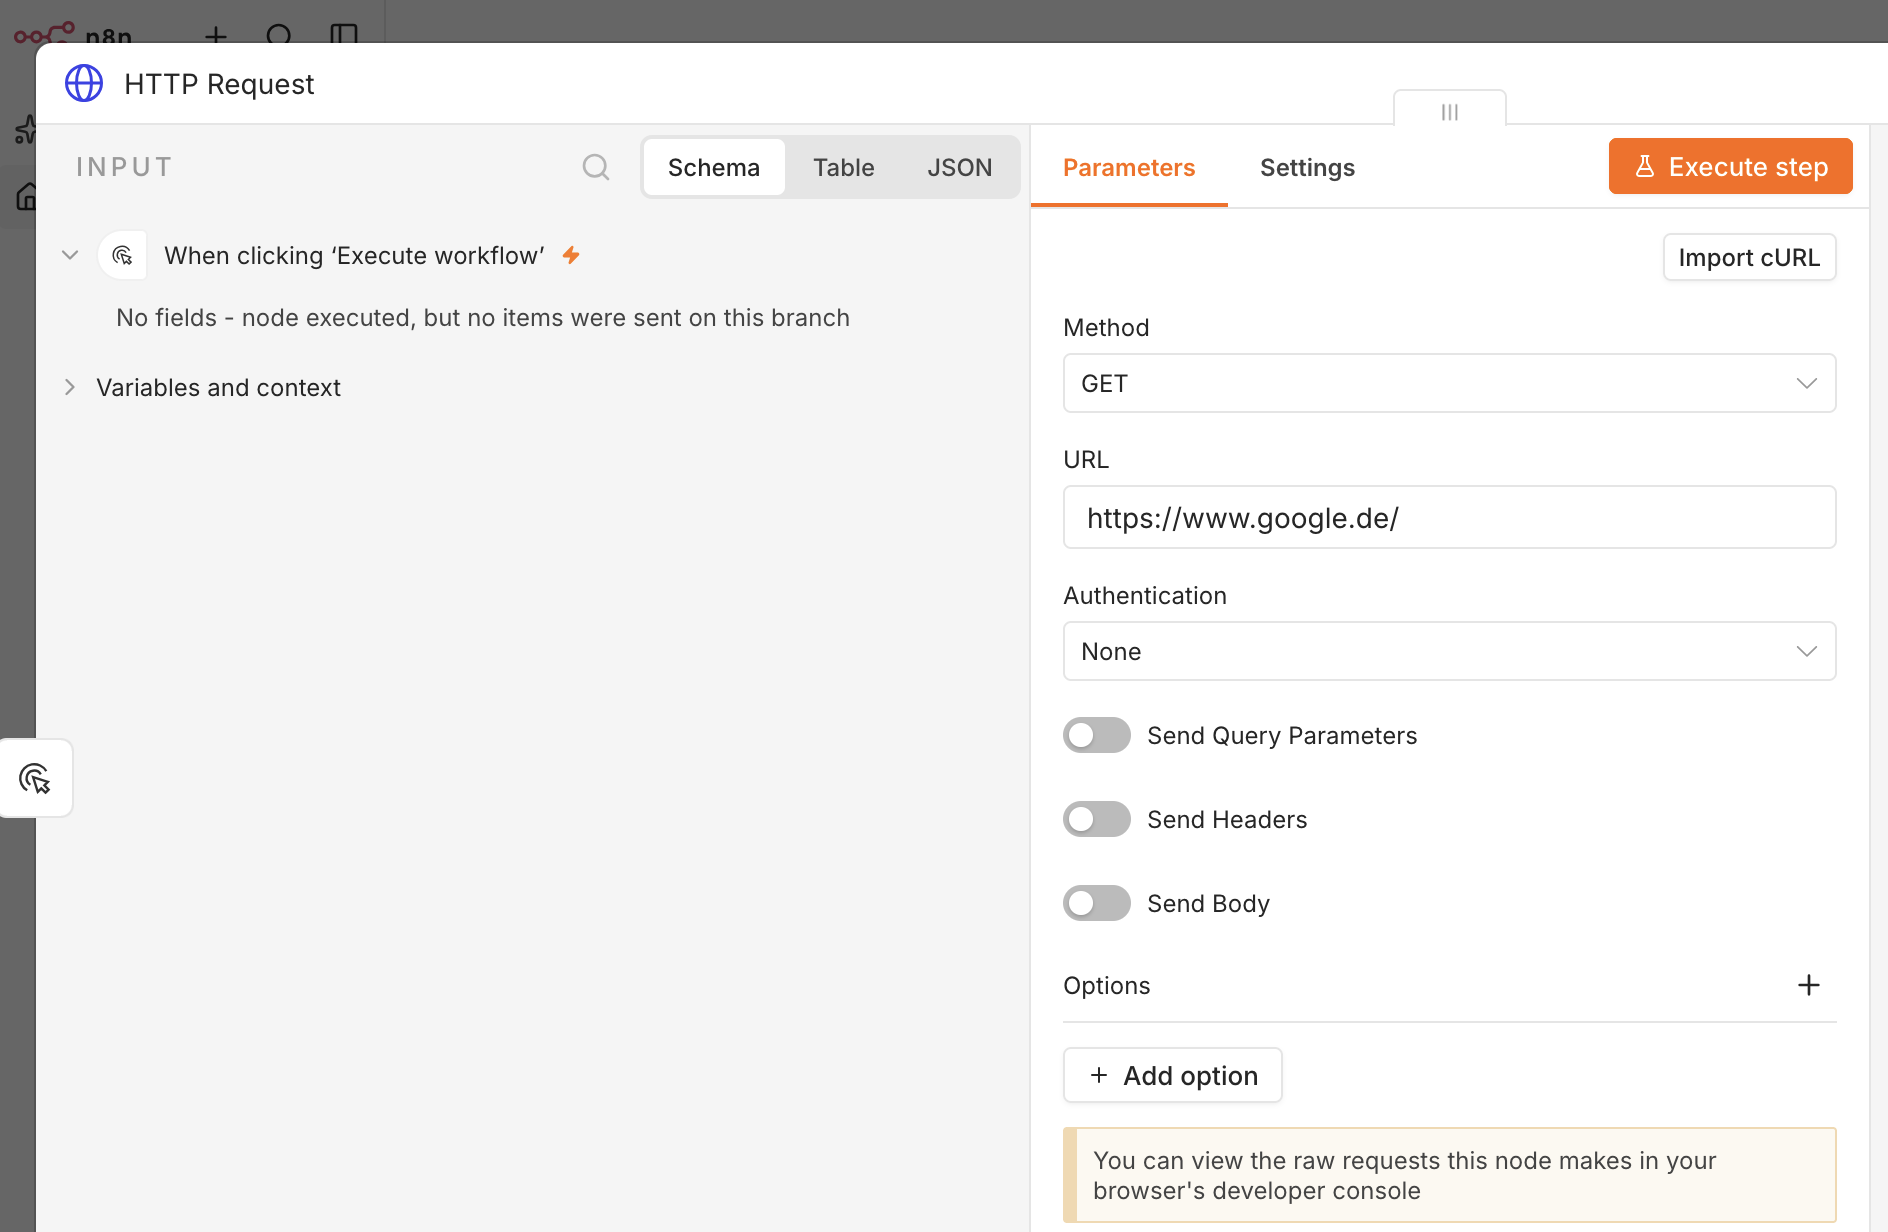
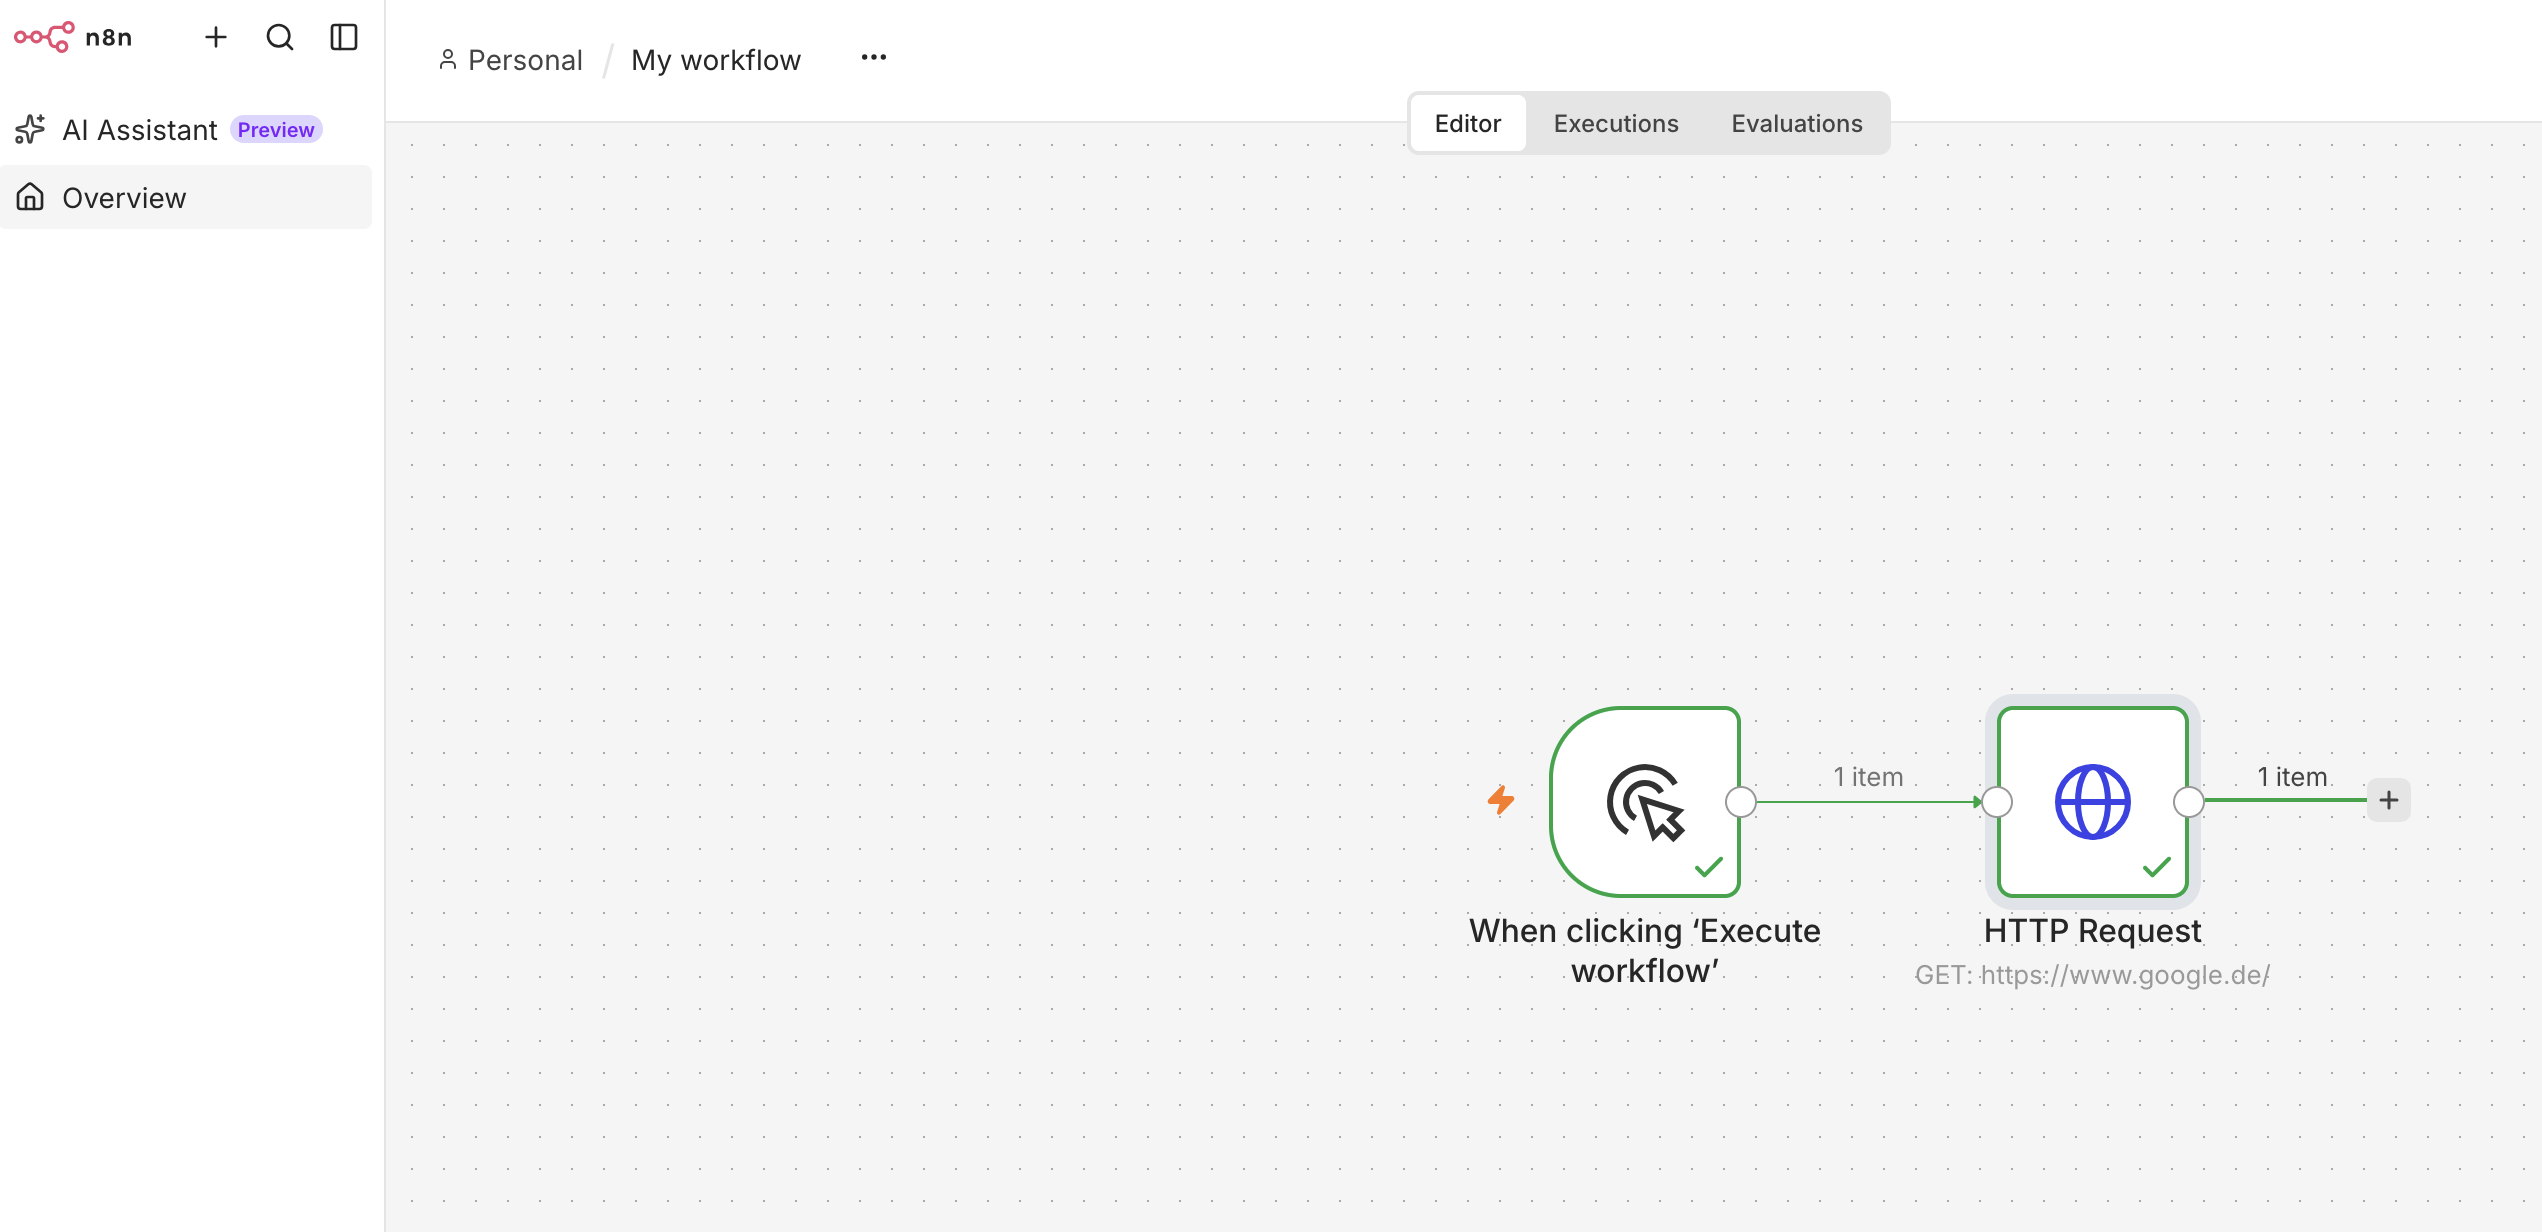
HTTP Request Node: Method GET, URL https://www.google.de/, Authentication None.Canvas: Manual Trigger und HTTP Request GET google.de, beide Nodes grün.
Dieser Test beweist noch keine produktive Integration. Er zeigt aber, dass n8n läuft, der Workflow ausgeführt wird und der Container eine externe HTTP Adresse erreichen kann.
Wer den Mini Workflow importieren möchte, kann dieses JSON verwenden:
Typische Docker Fehler bei der lokalen n8n Installation
Wichtig für späteres Ollama
Wenn n8n im Container läuft, ist localhost innerhalb des Containers nicht automatisch Ihr Rechner. Für einen Ollama Dienst auf dem Host verwenden Sie http://host.docker.internal:11434/v1.
Port 5678 ist bereits belegt
Ein anderer Container oder lokaler Dienst verwendet den Port. Prüfen Sie docker compose ps und die Fehlermeldung beim Start. Alternativ können Sie beispielsweise "5679:5678" verwenden und n8n anschließend über http://localhost:5679 aufrufen.
Safari zeigt einen Secure Cookie Fehler
Für den lokalen Test hilft N8N_SECURE_COOKIE=false. Für eine produktive Umgebung sollte stattdessen HTTPS verwendet werden.
Das Docker Volume wurde gelöscht
Verwenden Sie docker compose down -v nicht unbedacht. Der Parameter -v entfernt das Datenvolume. Ohne Backup können dabei Workflows, Credentials und andere Instanzdaten verloren gehen.
Der Container startet nicht
Logs helfen meist schneller als Änderungen an der Compose Datei:
docker compose logs -f n8n
Optional: lokales LLM mit Ollama
Bis hierhin ist n8n vollständig installiert. Ollama ist eine optionale Erweiterung, wenn Sie zusätzlich ein lokales Sprachmodell verwenden möchten.
Ollama kann auf dem Host installiert werden. Ein Modell wie qwen2.5:14b wird dann lokal ausgeführt. Die konkrete Geschwindigkeit hängt von Hardware, RAM, GPU und Modellvariante ab.
Prüfen Sie auf dem Host zunächst, ob Ollama läuft:
ollama list
curl http://127.0.0.1:11434/api/tags
Wenn n8n in Docker läuft und Ollama auf dem Host, darf die n8n Konfiguration nicht einfach localhost:11434 verwenden. Aus Sicht des Containers bezeichnet localhost den Container.
Verwenden Sie stattdessen:
http://host.docker.internal:11434/v1
Unter Linux ist der entsprechende extra_hosts Eintrag aus der Compose Datei wichtig.
Die lokale Modellnutzung bedeutet technisch: Der Modellprozess läuft auf Ihrer eigenen Infrastruktur. Das bedeutet nicht, dass jeder Workflow automatisch lokal bleibt. Sobald Sie beispielsweise eine externe API aufrufen, werden die dafür übertragenen Daten an diesen Dienst gesendet.
Optional: AI Assistant mit Ollama
Der n8n AI Assistant ist eine zusätzliche Funktion und für die normale Workflow Automatisierung nicht notwendig. Er kann beim Erstellen und Bearbeiten von Workflows unterstützen, benötigt für bestimmte Funktionen jedoch zusätzliche Infrastruktur.
Einstieg unter /assistant: Preview, drei Punkte zu Workflows, Debuggen und Hilfe, Button Set up.
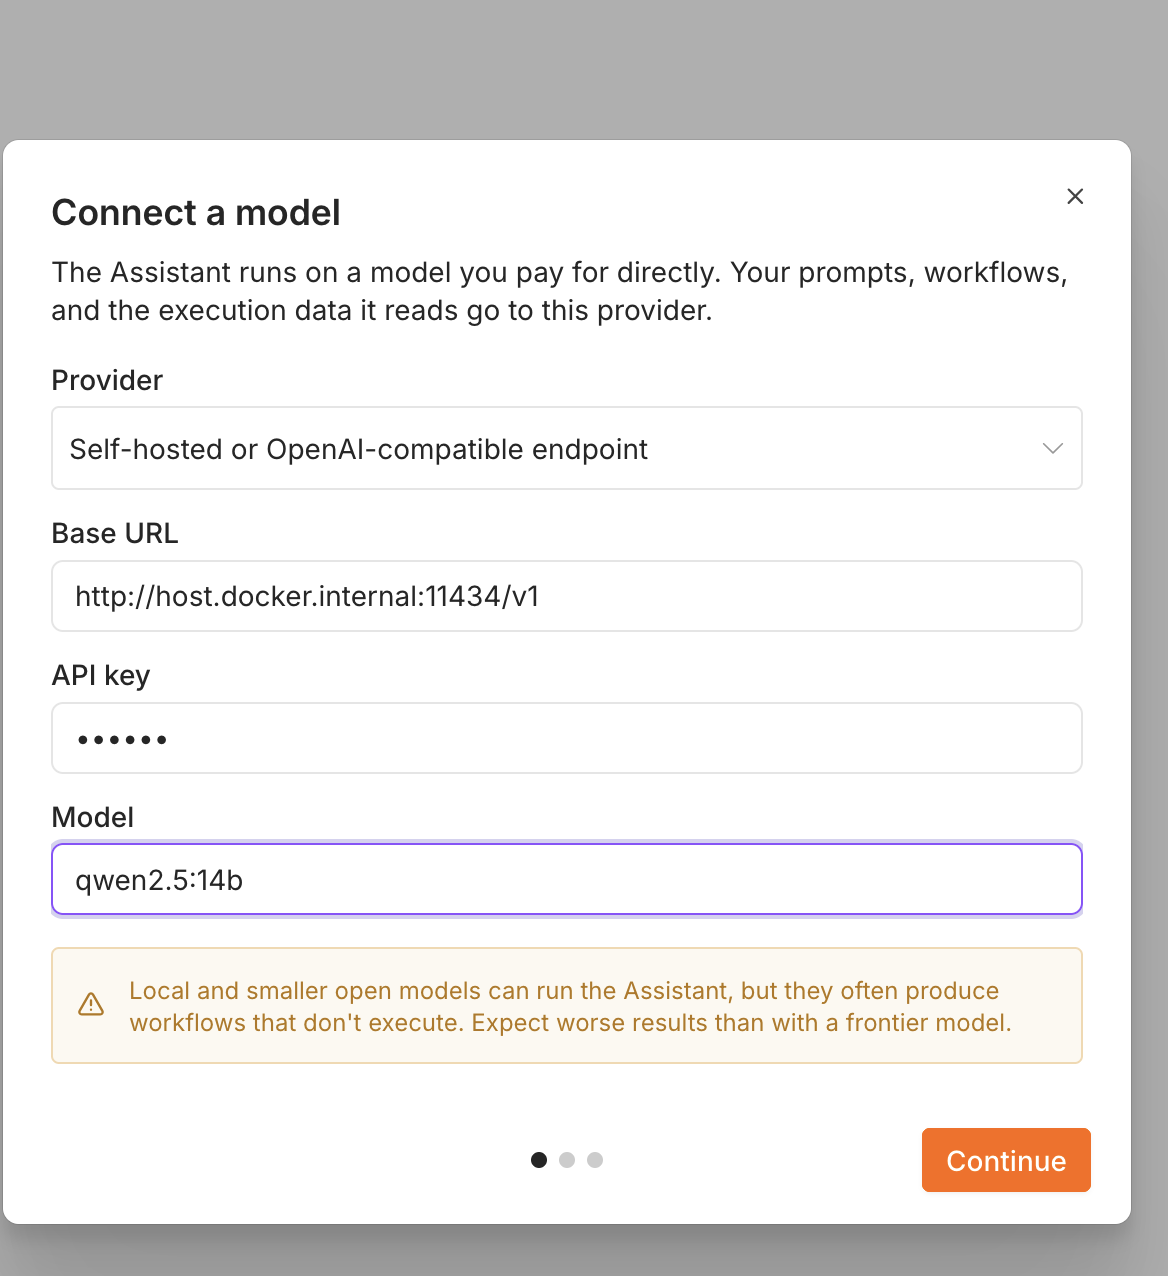
Für einen lokalen Test kann ein OpenAI kompatibler Ollama Endpunkt verwendet werden.
Feld
Wert
Provider
Self-hosted or OpenAI-compatible endpoint
Base URL
http://host.docker.internal:11434/v1
API Key
ollama
Model
qwen2.5:14b
Je nach n8n Version und verwendeter Modellkonfiguration können zusätzliche Einstellungen notwendig sein. Im getesteten Setup war insbesondere die Thinking Funktion relevant:
N8N_INSTANCE_AI_THINKING_ENABLED=false
Wenn Sie diese Variable ergänzen, muss der Container neu erstellt werden:
docker compose up -d --force-recreate
Code Sandbox
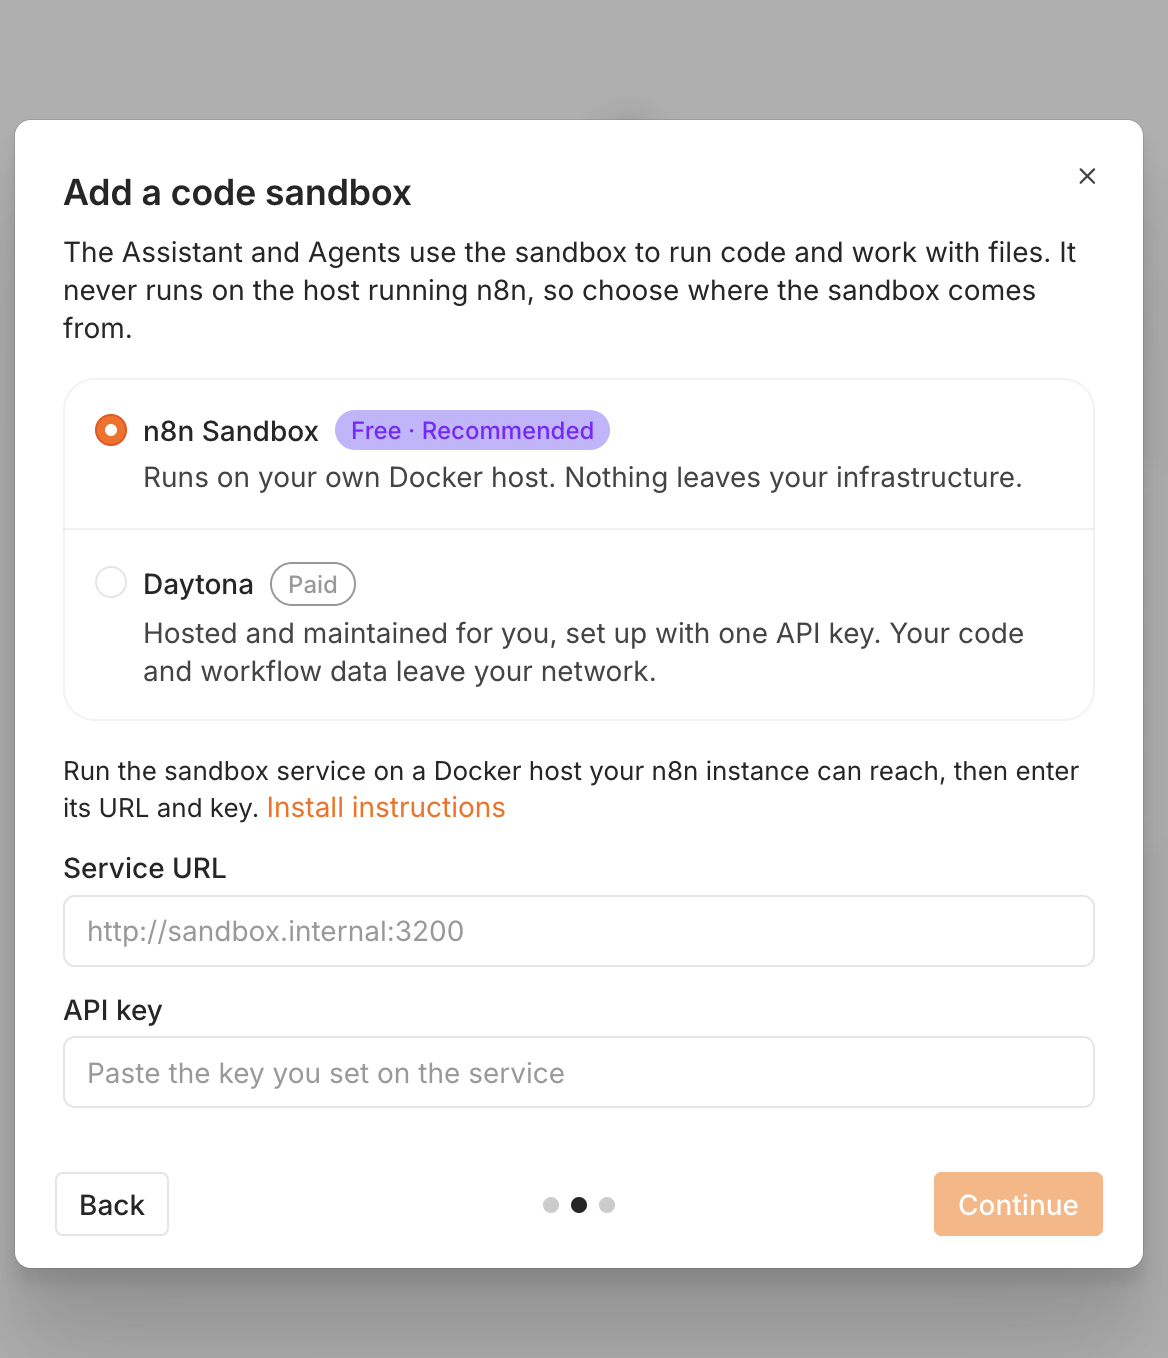
Für bestimmte Funktionen des AI Assistant wird zusätzlich eine isolierte Sandbox benötigt. Sie ist von der eigentlichen n8n Installation getrennt.
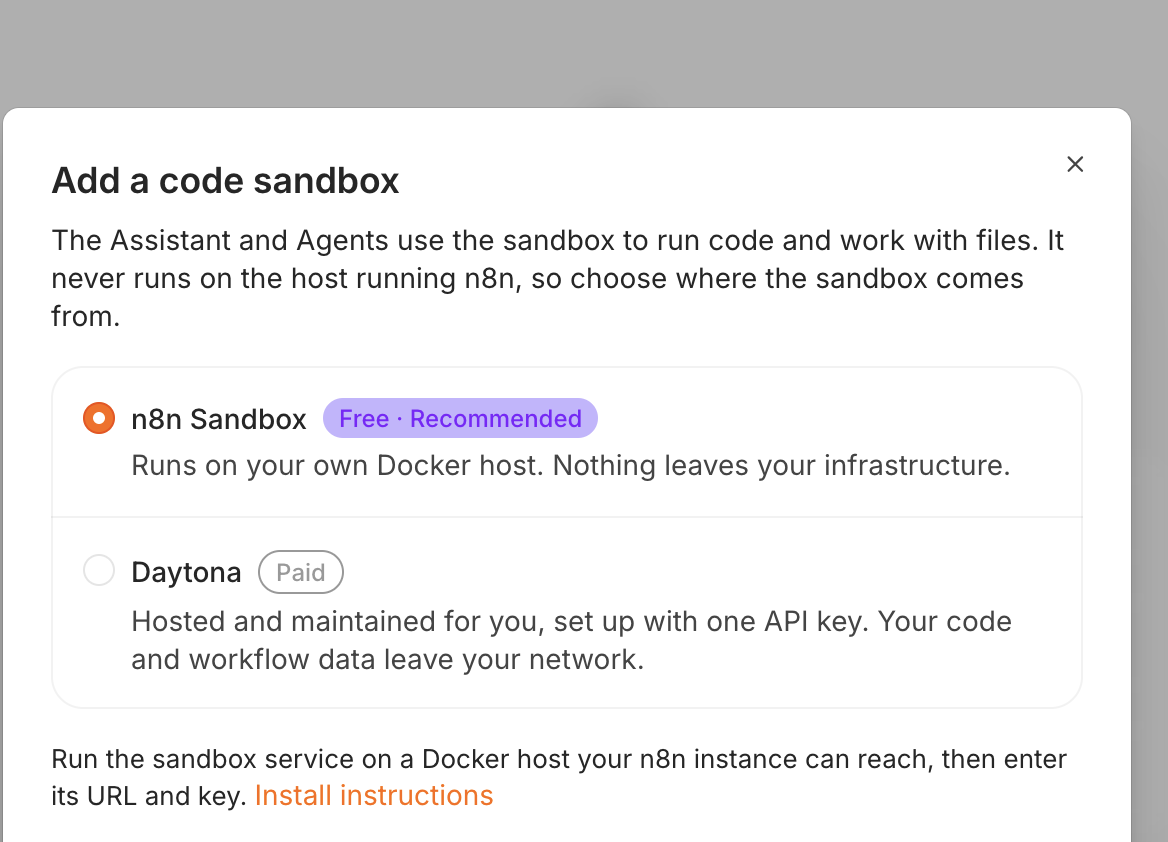
Wahl der Quelle: n8n Sandbox lokal und kostenlos, Daytona bezahlt. Daten würden bei Daytona das eigene Netz verlassen.Felder noch leer. Der Platzhalter http://sandbox.internal:3200 ist nur ein Beispiel, keine echte Adresse.
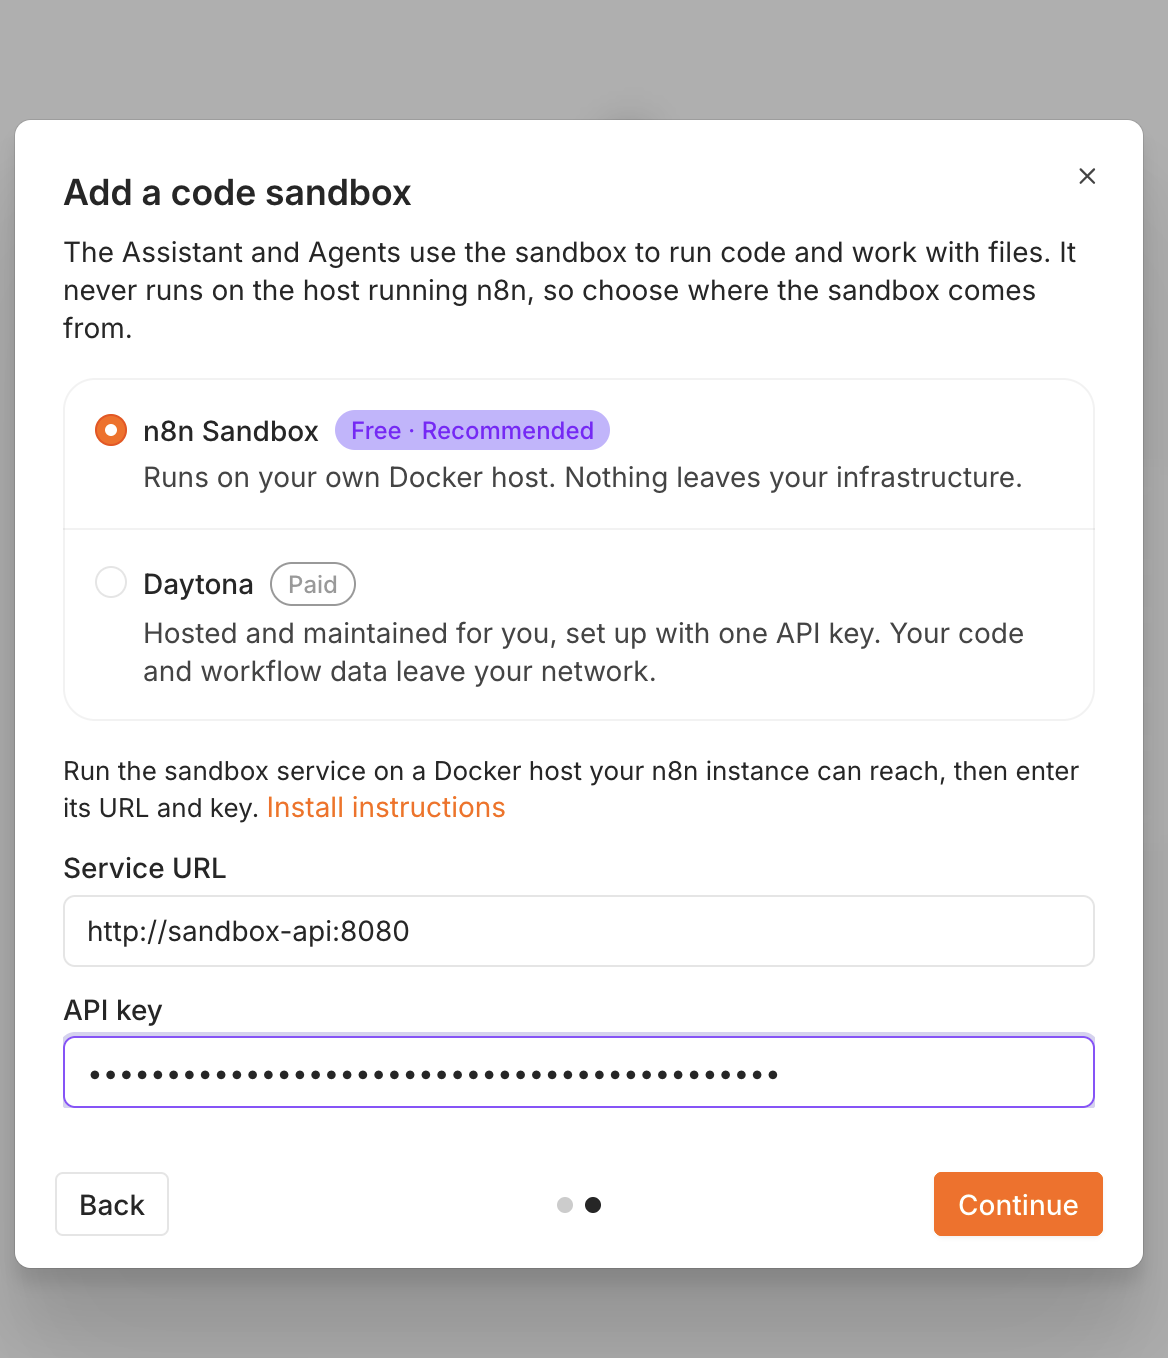
Für einen lokalen Test kann die Sandbox selbst betrieben werden. Die konkrete Einrichtung hängt vom verwendeten n8n Stand ab. Die aktuelle Dokumentation beschreibt die dafür erforderlichen Container und Umgebungsvariablen.
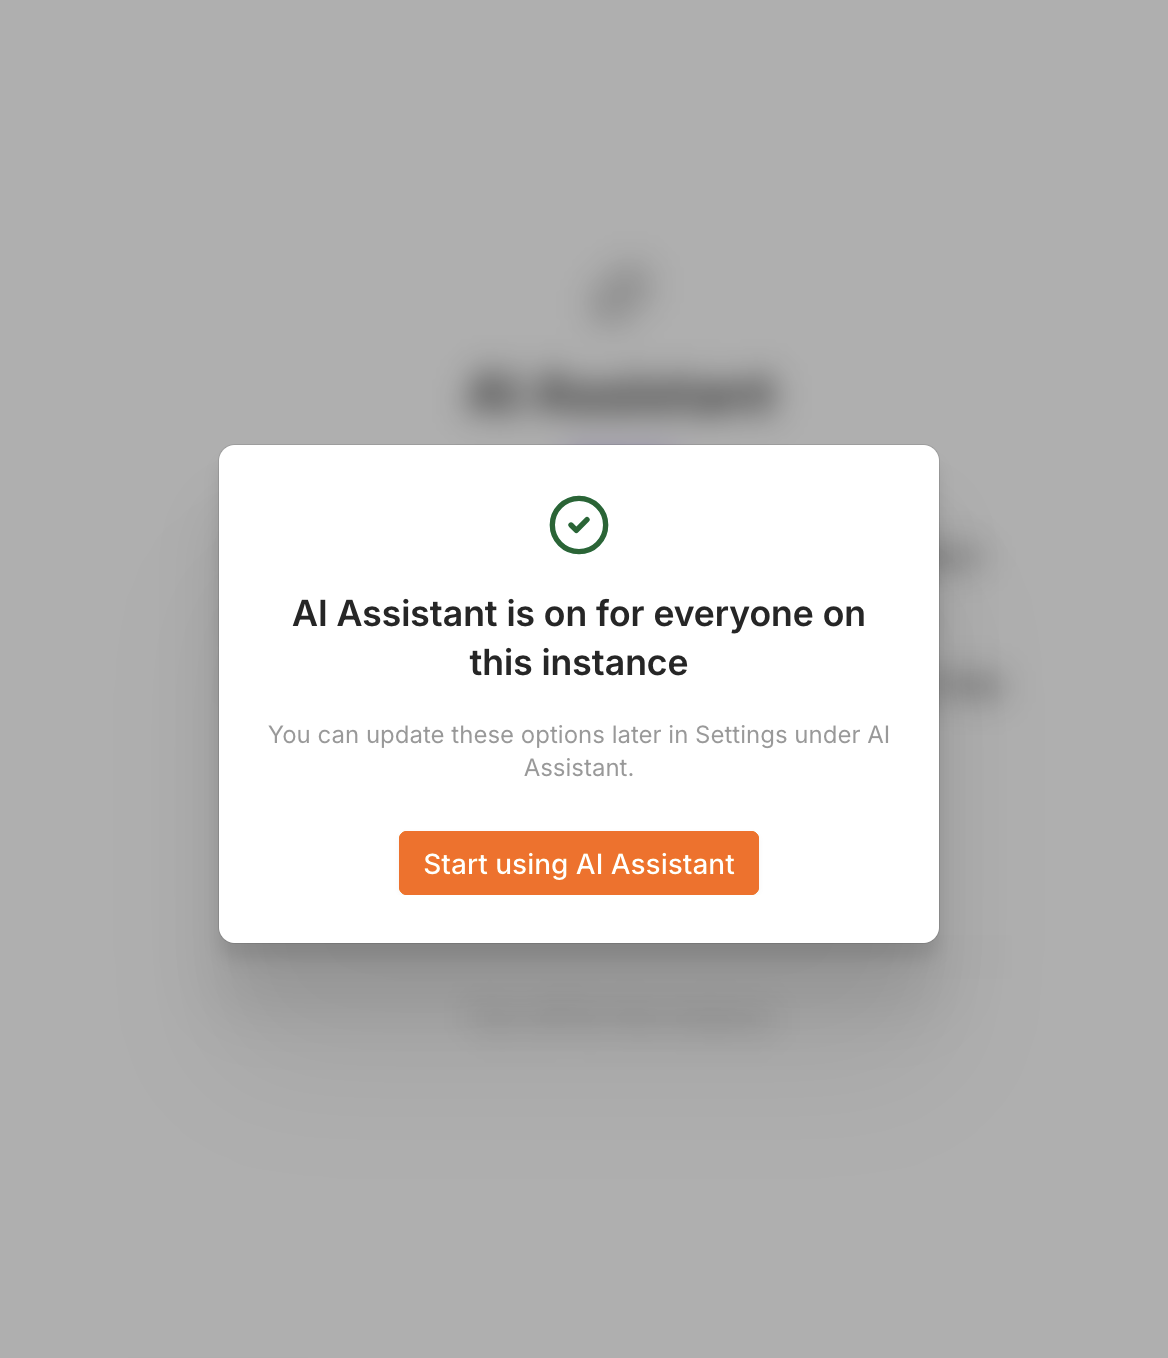
Service URL http://sandbox-api:8080, API-Key aus der eigenen Konfiguration. Continue ist danach aktiv.Abschluss: AI Assistant is on for everyone on this instance. Änderungen später unter Settings.
Für einen reinen n8n Test können Sie diesen gesamten Abschnitt überspringen.
Was ein lokales 14B Modell leisten kann
Ein lokales 14B Modell kann in n8n sinnvoll sein, wenn Sie Texte klassifizieren, zusammenfassen oder strukturieren möchten. Die Qualität hängt jedoch stark von Modell, Prompt, Kontext und Hardware ab.
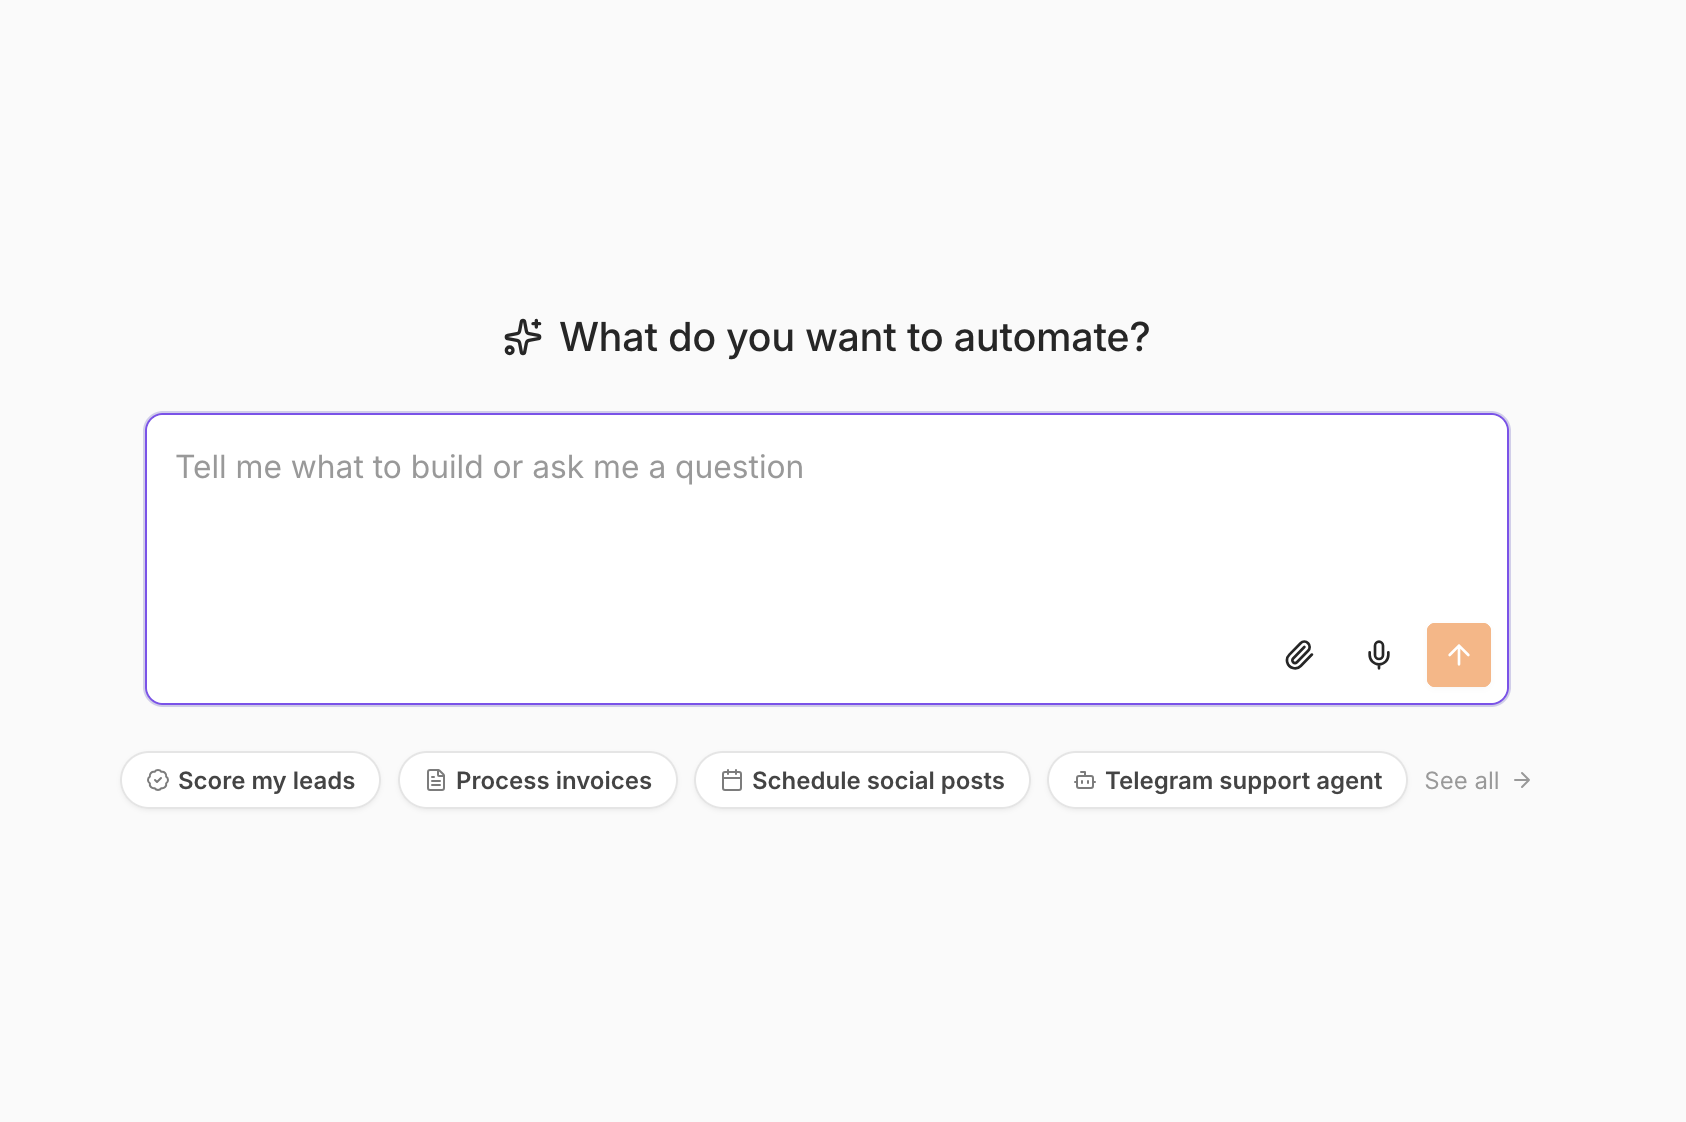
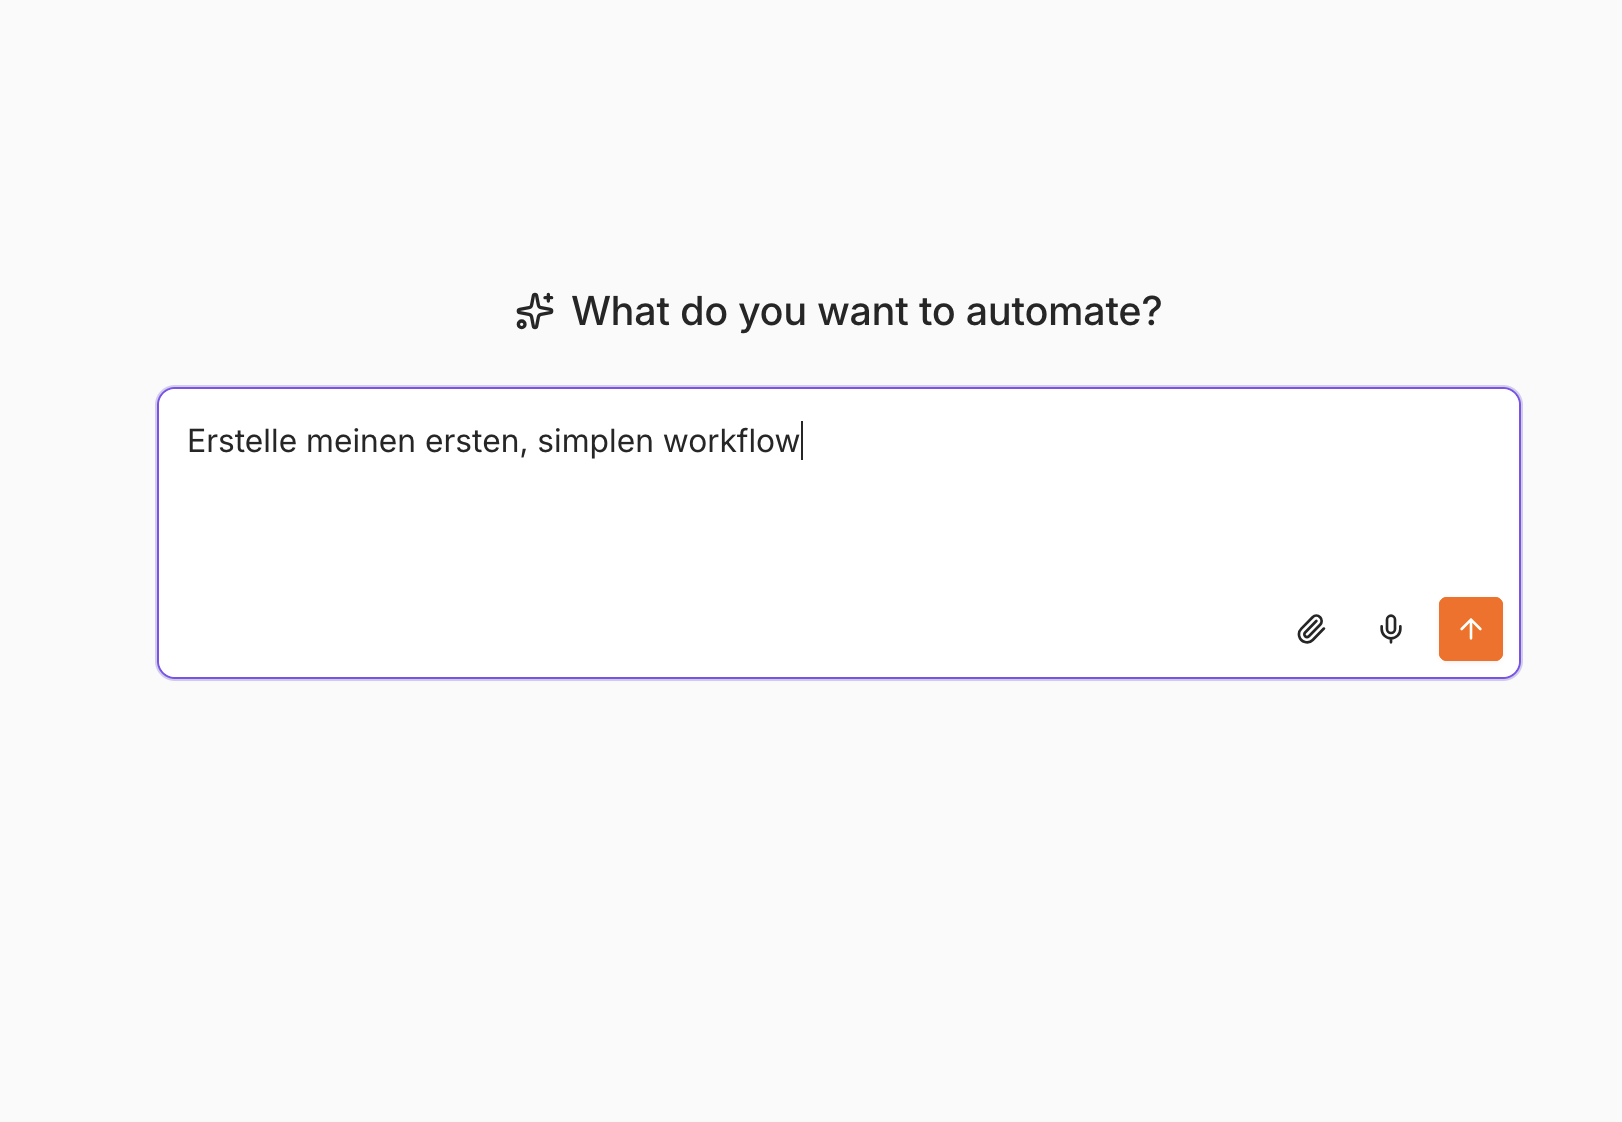
Leere Startseite: What do you want to automate? Vorschläge wie Process invoices oder Telegram support agent.Im Eingabefeld: Erstelle meinen ersten, simplen workflow. Ohne konkrete Nodes bleibt der Auftrag unscharf.
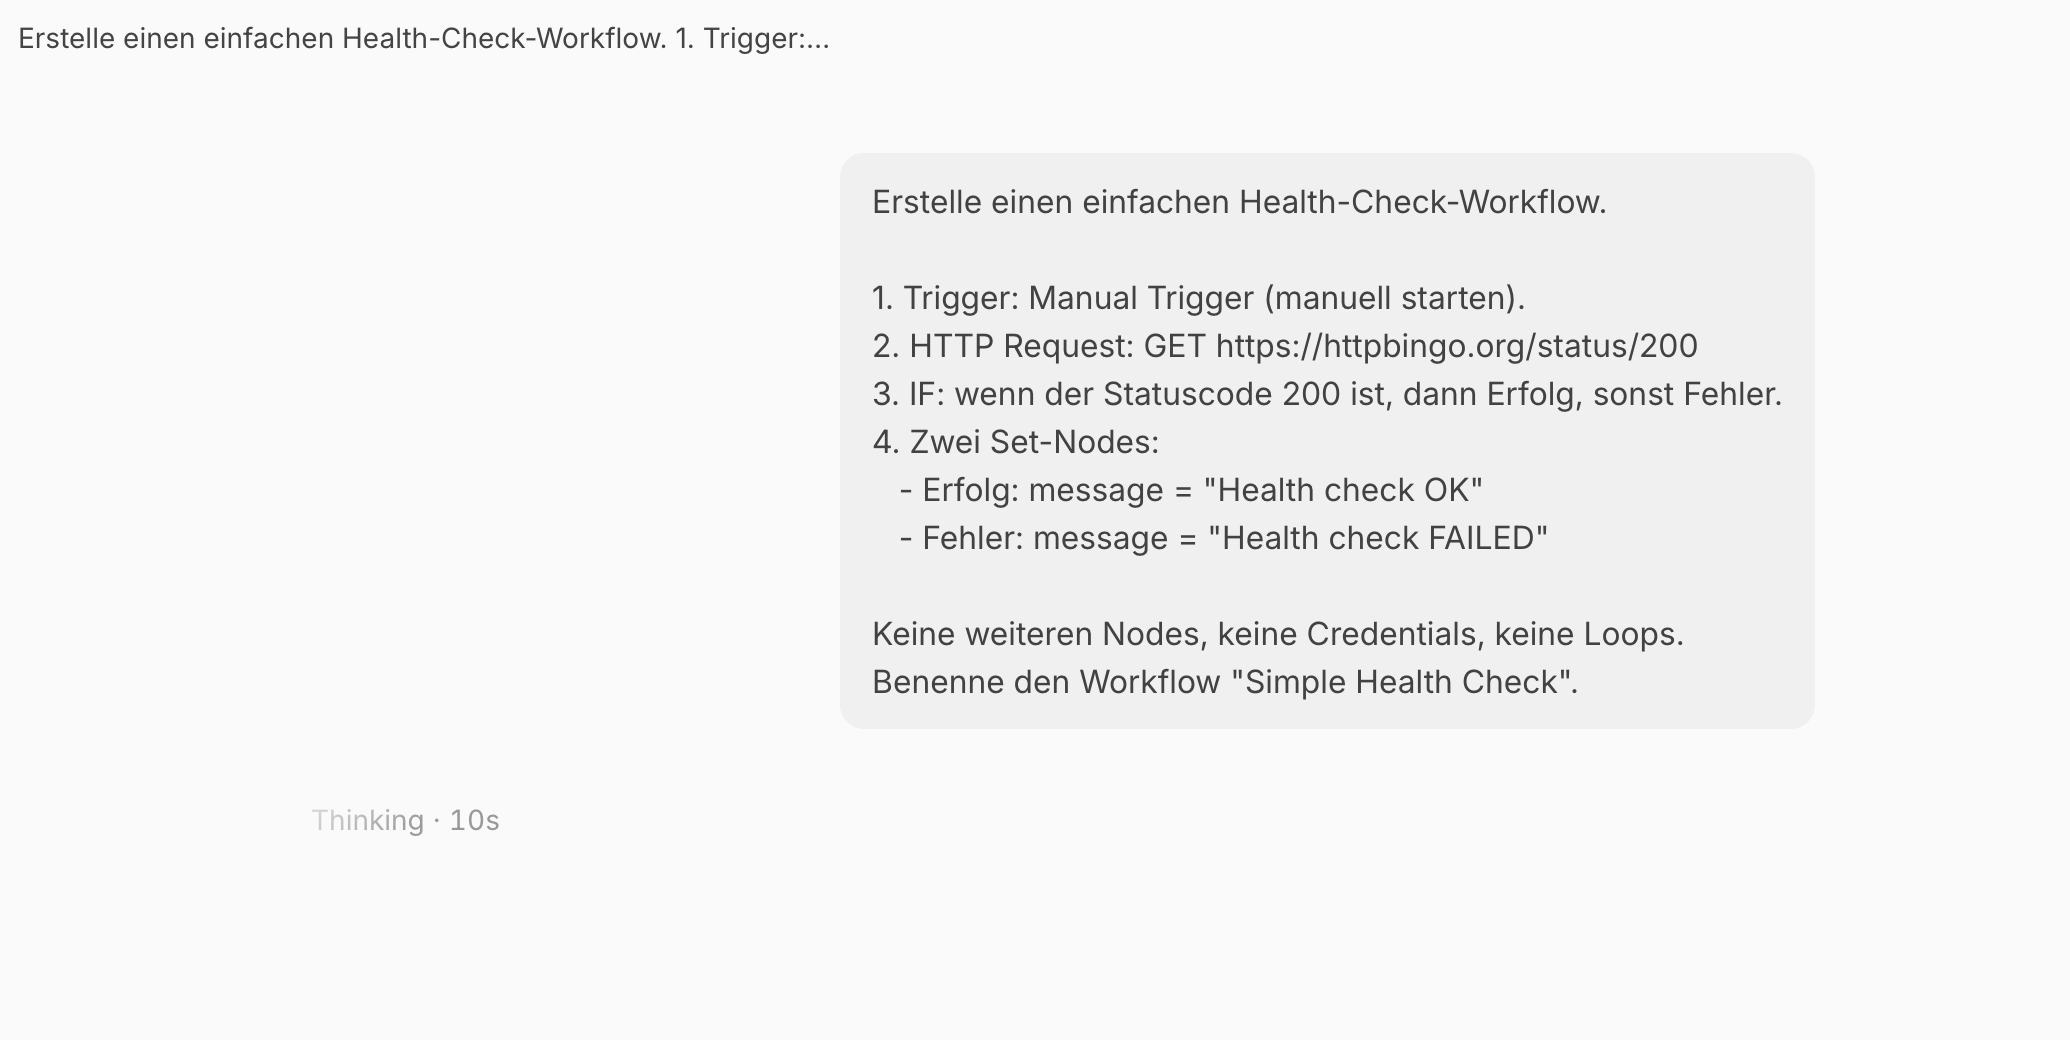
Ein konkreter Test mit einem kleinen Health Check zeigte die Grenze des lokalen Modells: Es erzeugte teilweise Platzhalter und beschrieb Schritte, die nicht zuverlässig als fertiger Workflow umgesetzt wurden.
Konkreter Health-Check-Prompt mit wenigen Nodes. Unten Thinking, ohne dass ein belastbarer Workflow entsteht.
Das ist ein wichtiger Unterschied: Ein lokales LLM kann ein sinnvoller Bestandteil eines n8n Workflows sein, muss aber nicht gleichzeitig der beste Architekt für komplexe Workflows sein.
Für das Erzeugen und Verändern komplexer Workflows kann ein leistungsfähigeres Modell sinnvoll sein. Für Klassifizierung, Zusammenfassung oder strukturierte Textausgabe kann ein lokales Modell dagegen sehr gut passen.
Was in ein Unternehmen übertragbar ist
Die Basisinstallation ist einfach. Docker, Volume und n8n Container reichen für einen ersten Test.
Der produktive Betrieb ist eine andere Aufgabe. Backups, Updates, HTTPS, Zugriffsschutz und Monitoring müssen separat geplant werden.
Lokale KI ist eine Architekturentscheidung. Ein lokales Modell kann Datenverarbeitung innerhalb der eigenen Infrastruktur ermöglichen. Externe Schnittstellen können trotzdem Daten nach außen übertragen.
n8n und LLM haben unterschiedliche Aufgaben. n8n orchestriert den Prozess. Das Modell verarbeitet unstrukturierte Inhalte.
Hybrid kann sinnvoll sein. Kritische Inhalte können lokal verarbeitet werden, während für weniger sensible Aufgaben ein leistungsfähiger externer Dienst verwendet wird.
Für den Übergang vom Test zum Unternehmensbetrieb sollten Sie deshalb nicht einfach die Compose Datei auf einen Server kopieren. Prüfen Sie zuerst Datenflüsse, Benutzerrechte, Schnittstellen, Backup Strategie und externe Dienste.
Was lässt sich mit n8n und einem lokalen LLM automatisieren?
Die Kombination aus n8n und einem lokalen Sprachmodell ist besonders interessant bei Prozessen, in denen klassische Regeln und unstrukturierte Inhalte zusammenkommen.
Eingehende E-Mails: n8n kann Nachrichten verarbeiten, Anhänge speichern und Daten an ein Fachsystem übertragen. Ein lokales Modell kann zusätzlich Betreff oder Text klassifizieren.
Dokumentenklassifizierung: Dokumente können verarbeitet und nach Typ oder Inhalt eingeordnet werden. Unsichere Fälle können zur manuellen Prüfung weitergegeben werden.
Interne KI Wissensdatenbank: n8n kann Datenflüsse rund um Dokumente automatisieren. Die eigentliche Wissensdatenbank benötigt zusätzlich Indexierung, Berechtigungen und eine geeignete Sucharchitektur.
CRM Prozesse: n8n kann neue Leads prüfen, Aufgaben erzeugen und Systeme synchronisieren. KI kann bei unstrukturierten Notizen unterstützen.
Helpdesk: Tickets können vorqualifiziert, kategorisiert und mit ähnlichen Fällen angereichert werden.
Besprechungsnotizen: Transkripte können zusammengefasst und offene Punkte automatisch weiterverarbeitet werden.
ERP und DMS: Viele Integrationen benötigen überhaupt kein LLM. KI wird dort interessant, wo Informationen nicht strukturiert vorliegen.
Welche Architektur sinnvoll ist, hängt vom jeweiligen Prozess und den Daten ab. Einen Überblick über typische Szenarien finden Sie auf der Seite zur KI Automatisierung.
Häufige Fragen
Ist n8n wirklich kostenlos?
Die hier beschriebene selbst gehostete Variante kann ohne Lizenzgebühr betrieben werden. Trotzdem entstehen eigene Betriebskosten für Hardware, Strom, Administration und gegebenenfalls externe Dienste. Prüfen Sie vor einem produktiven Einsatz die aktuellen n8n Lizenzbedingungen.
Funktioniert die Anleitung auf Windows, Linux und Mac?
Ja. Docker abstrahiert einen großen Teil der Betriebssystemunterschiede. Die Screenshots stammen vom Mac. Einzelne Details wie Safari oder GPU Unterstützung können sich unterscheiden.
Muss Ollama installiert werden?
Nein. Ollama ist für diese Anleitung optional. Die n8n Basisinstallation und normale Workflows funktionieren ohne lokales Sprachmodell.
Warum funktioniert localhost:11434 in n8n nicht?
Weil n8n im Docker Container läuft. localhost bezeichnet dort den Container. Wenn Ollama auf dem Host läuft, verwenden Sie http://host.docker.internal:11434/v1.
Kann ich den AI Assistant weglassen?
Ja. Der AI Assistant ist keine Voraussetzung für n8n. Wenn Sie nur Automatisierung testen möchten, können Sie ihn komplett überspringen.
Ist eine lokale Installation automatisch DSGVO konform?
Nein. Eine lokale Installation kann die Datenflüsse reduzieren, ersetzt aber keine Datenschutzprüfung. Entscheidend ist, welche Daten Ihre Workflows verarbeiten und welche externen Systeme sie aufrufen.
Kann ich später auf einen Linux Server umziehen?
Ja. Docker und das Datenvolume erleichtern den Umzug. Für einen produktiven Betrieb müssen zusätzlich Netzwerk, HTTPS, Backup, Zugriffsschutz und Updates geplant werden.
Brauche ich eine GPU?
Für n8n nicht. Ein lokales Sprachmodell kann auch auf der CPU laufen, wird bei größeren Modellen aber häufig deutlich langsamer. Eine geeignete GPU kann die Modellverarbeitung beschleunigen.
Kann ich n8n öffentlich erreichbar machen?
Die hier gezeigte Konfiguration ist für einen lokalen Test gedacht. Für öffentliche Webhooks benötigen Sie eine deutlich umfangreichere Betriebsarchitektur mit HTTPS, Zugriffsschutz und einem bewusst konfigurierten Netzwerk.
Wie aktualisiere ich n8n?
Das Datenvolume darf dabei nicht gelöscht werden. Für die gezeigte Testumgebung reicht normalerweise:
docker compose pull
docker compose up -d
Vor größeren Versionssprüngen sollten Sie ein Backup erstellen und die aktuellen Release Hinweise prüfen.
Kann n8n eine KI Wissensdatenbank ersetzen?
Nein. n8n ist die Automatisierungsplattform. Eine Wissensdatenbank benötigt zusätzlich Indexierung, Dokumentenverwaltung, Berechtigungen und eine geeignete Such beziehungsweise RAG Architektur. n8n kann die dafür notwendigen Datenflüsse automatisieren.
Fazit
n8n lokal zu installieren ist mit Docker vergleichsweise einfach. Die Basis besteht aus einem Container, einem persistenten Volume und der Weboberfläche unter localhost:5678. Die gleiche grundsätzliche Konfiguration lässt sich auf Windows, Linux und macOS verwenden.
Der entscheidende Punkt ist die Trennung zwischen Basisinstallation und KI Erweiterung. Für n8n selbst benötigen Sie kein Ollama und keinen AI Assistant. Erst wenn Sie lokale KI in Workflows einsetzen möchten, kommt Ollama mit einem passenden Modell hinzu.
Ein lokales LLM kann dabei interessante Aufgaben übernehmen: klassifizieren, zusammenfassen, strukturieren oder Texte erzeugen. Es ist aber nicht automatisch die beste Wahl für komplexe Agenten oder das zuverlässige Erzeugen kompletter Workflows.
Auch „lokal“ bedeutet nicht automatisch „DSGVO konform“. Die tatsächlichen Datenflüsse hängen von Ihrer Architektur ab. Sobald ein Workflow externe APIs, Cloud Modelle oder andere Dienste verwendet, müssen diese Datenflüsse separat betrachtet werden.
Für Unternehmen ist deshalb weniger die Installation selbst entscheidend als die Frage, welcher Prozess automatisiert werden soll, welche Systeme beteiligt sind und welche Daten verarbeitet werden. n8n kann dabei die technische Orchestrierung übernehmen. Ein lokales LLM kann die unstrukturierten Teile ergänzen.
Welche Einsatzszenarien sich für mittelständische Unternehmen anbieten, zeige ich auf der Seite KI für den Mittelstand. Einen Überblick über die Kombination aus klassischen Workflows und KI finden Sie unter KI Automatisierung. Für interne Dokumente und Wissensbestände gibt es die KI Wissensdatenbank.
Wenn Sie Automatisierung im eigenen Netz planen und noch nicht wissen, ob n8n, ein lokales Modell oder eine Cloud KI zum Prozess passt, ist ein kleiner Prototyp meist der sinnvollste erste Schritt.
In 15 Minuten lässt sich unverbindlich klären, welche Architektur zu Ihren Daten und Schnittstellen passt. Zum Erstgespräch.
Eine lokale KI ist noch lange keine sichere KI
Eine lokale KI klingt zunächst nach einer ziemlich einfachen Antwort auf viele Fragen, die Unternehmen aktuell beschäftigen.
Das Sprachmodell läuft auf eigener Hardware. Die Daten verlassen das Unternehmen nicht. Keine externen APIs, keine fremde Cloud, keine unkontrollierbare Datenübertragung.
Technisch ist das heute vergleichsweise einfach umzusetzen. Mit Projekten wie Ollama lassen sich moderne Sprachmodelle innerhalb weniger Minuten lokal betreiben.
Aber damit ist eine entscheidende Frage noch nicht beantwortet:
Was darf diese KI eigentlich?
Genau diese Frage wird meiner Meinung nach in vielen Diskussionen über lokale KI bisher zu wenig betrachtet.
Denn sobald aus einem Sprachmodell mehr als ein Chatbot wird und es tatsächlich mit Unternehmensdaten und Unternehmenssystemen arbeiten soll, geht es nicht mehr nur um das richtige Modell. Es geht um Identitäten, Berechtigungen und kontrollierte Aktionen.
Das Problem beginnt mit dem ersten Zugriff
Nehmen wir ein einfaches Beispiel.
Ein Unternehmen betreibt eine lokale KI auf einem Linux-Server. Die KI soll interne Dokumente durchsuchen können.
Technisch könnte man dem entsprechenden Prozess einfach Zugriff auf einen Ordner geben:
/data/knowledge
Die Dokumente werden indexiert, in einer Vektordatenbank abgelegt und können anschließend über einen RAG-Ansatz durchsucht werden. Genau so entsteht in der Praxis oft der Einstieg in eine KI-Wissensdatenbank.
Das funktioniert.
Interessant wird es, sobald die KI zusätzlich auf andere Daten zugreifen oder Aktionen ausführen soll.
Vielleicht auf:
/data/knowledge
/data/projects
/data/templates
/data/crm
Vielleicht soll sie Dokumente erstellen dürfen, aber keine bestehenden Dokumente überschreiben.
Vielleicht darf sie bestimmte Daten nur lesen.
Vielleicht soll sie später sogar Aktionen in einem ERP-System durchführen können.
Spätestens dann reicht die Aussage „Die KI läuft lokal“ nicht mehr aus.
Lokale KI mit verschiedenen Datenquellen und Systemen
Lokales Sprachmodell
Ollama, vLLM oder vergleichbare Inference
/data/knowledge Dokumente
/data/projects Projekte
/data/templates Vorlagen
/data/crm CRM-Daten
ERP Aktionen
Ohne klare Rechte sieht die KI potenziell alles, an das der Prozess technisch angebunden ist.
Eine KI sollte nicht automatisch alles sehen dürfen
Ein naheliegender Ansatz ist, die KI unter einem eigenen technischen Benutzer laufen zu lassen.
Auf Linux könnte beispielsweise ein dedizierter Service-Account verwendet werden:
user: ai-reader
Dieser Benutzer bekommt ausschließlich die Rechte, die für seine Aufgabe notwendig sind.
Zum Beispiel:
Pfad
Recht
/data/knowledge
read
/data/drafts
read/write
/data/finance
no access
/etc
no access
/home
no access
Die Idee dahinter ist nicht neu. Sie entspricht einem Grundprinzip klassischer IT-Sicherheit: Least Privilege.
Ein Dienst bekommt nur die Berechtigungen, die er tatsächlich benötigt.
Für eine lokale KI ist dieses Prinzip besonders relevant. Denn ein lokal laufendes Modell kann genauso mit zu weitreichenden Berechtigungen ausgestattet werden wie jeder andere Prozess.
Aber der Service-Account allein reicht nicht
Bisher haben wir nur eine Frage beantwortet:
Was darf dieser KI-Dienst grundsätzlich?
In einer Unternehmensumgebung gibt es aber eine zweite Dimension:
Was darf der konkrete Mitarbeiter?
Nehmen wir zwei Mitarbeiter.
Mitarbeiter A arbeitet im Vertrieb.
Mitarbeiter B arbeitet in der Personalabteilung.
Beide verwenden dieselbe interne KI.
Der Vertriebsmitarbeiter darf auf Angebote, Kundendaten und Vertriebsdokumente zugreifen. Die Personalabteilung darf auf Personalunterlagen zugreifen.
Die KI sollte deshalb nicht einfach sagen: „Ich bin lokal installiert und darf alles lesen.“
Sie muss den Kontext des Benutzers berücksichtigen.
Damit entstehen zwei getrennte Berechtigungsebenen.
Menschliche Identität und technische KI-Identität
Mensch
Mitarbeiteridentität
Active Directory, Entra ID oder LDAP. Vertrieb darf CRM sehen, Personal darf Personalakten sehen.
KI
Technische Identität
ai-reader, ai-editor, ai-crm, ai-erp. Jeder Agent hat nur die Rechte für seine Aufgabe.
Mensch und KI brauchen unterschiedliche Identitäten
Der menschliche Benutzer besitzt eine Identität, zum Beispiel über Active Directory, Entra ID oder LDAP.
Die KI beziehungsweise ein einzelner KI-Agent besitzt ebenfalls eine technische Identität.
Zum Beispiel:
ai-reader
ai-editor
ai-crm
ai-erp
Diese technischen Identitäten können jeweils unterschiedliche Rechte und Fähigkeiten besitzen.
Damit lässt sich ein relativ einfaches Grundmodell formulieren:
Der Mitarbeiter bringt seine Berechtigungen mit. Der KI-Agent bringt seine eigenen Fähigkeiten und Einschränkungen mit. Eine konkrete Aktion sollte nur möglich sein, wenn beide Ebenen sie zulassen.
Das ist bewusst vereinfacht. In einer realen Umgebung können zusätzlich Faktoren wie Datenklassifizierung, konkrete Ressource, Zweck, Freigaben oder das Risiko der Aktion eine Rolle spielen.
Genau deshalb wird aus der Frage nach einem Service-Account zunehmend eine Frage nach einer eigenen Zugriffsschicht.
Die KI sollte nicht direkt mit dem Dateisystem arbeiten
Noch einen Schritt weiter gedacht würde ich dem Sprachmodell selbst möglichst wenig direkte Rechte geben.
Das Modell sollte nicht einfach Shell-Befehle ausführen oder beliebige Dateien verändern können.
Stattdessen sollte es klar definierte Werkzeuge verwenden.
Zum Beispiel:
search_documents()
create_draft()
read_customer()
create_offer()
create_ticket()
Das Modell kann damit nicht beliebige Aktionen ausführen. Es kann lediglich eine definierte Aktion anfordern.
Eine weitere Schicht entscheidet anschließend, ob diese Aktion erlaubt ist.
LLM, Policy Engine, Tool, Unternehmenssystem
Mitarbeiter stellt eine Anfrage
KI-Agent fordert eine Aktion an, zum Beispiel create_offer
Policy Engine prüft Benutzer, Agent, Daten, Aktion, Freigabe und Protokollierung
Tool führt die Aktion nur bei Freigabe aus
CRM, ERP oder Dateisystem bleibt die eigentliche Quelle der Daten und ihrer Berechtigungen
Das könnte beispielsweise so aussehen:
Mitarbeiter
    ↓
KI-Agent
    ↓
"create_offer"
    ↓
Policy Engine
    ↓
Ist dieser Benutzer dazu berechtigt?
Ist dieser Agent dazu berechtigt?
Sind die benötigten Daten freigegeben?
Ist eine menschliche Bestätigung erforderlich?
    ↓
Tool
    ↓
CRM / ERP / Dateisystem
Damit wird das Sprachmodell selbst zu einem relativ kleinen Teil des Systems.
Die eigentliche Kontrolle liegt außerhalb des Modells.
Und plötzlich wird aus einem Chatbot ein Berechtigungsproblem
Genau an diesem Punkt verändert sich meiner Meinung nach die Perspektive auf Unternehmens-KI.
Solange eine KI lediglich Fragen beantwortet, ist das Berechtigungsproblem vergleichsweise überschaubar.
Sobald die KI aber handeln darf, verändert sich die Situation. Genau dort beginnt KI-Automatisierung: nicht beim Chat, sondern bei definierten Aktionen in bestehenden Systemen.
Eine KI soll vielleicht:
Dokumente lesen.
Dokumente erstellen.
E-Mails vorbereiten.
Tickets anlegen.
CRM-Daten aktualisieren.
Angebote erstellen.
Informationen aus einem ERP-System abrufen.
Oder irgendwann sogar administrative Aufgaben durchführen.
Jede dieser Aktionen besitzt ein eigenes Risiko und benötigt eigene Berechtigungen.
Eine KI, die ein Dokument zusammenfassen darf, braucht nicht automatisch das Recht, dieses Dokument zu löschen.
Eine KI, die einen Entwurf für ein Angebot erstellen darf, muss nicht automatisch Angebote versenden dürfen.
Eine KI, die Server-Logs lesen darf, sollte nicht automatisch Serverkonfigurationen verändern können.
Bei klassischen Softwareanwendungen bauen wir solche Grenzen seit Jahren. Bei KI-Agenten müssen wir anfangen, dieselben Prinzipien konsequent anzuwenden.
Bevor ein Agent solche Aktionen ausführen soll, lohnt sich deshalb zuerst die Frage, ob KI für den Prozess überhaupt der richtige Weg ist. Dafür gibt es den KI-Check.
Das Betriebssystem liefert bereits einen Teil der Lösung
Interessant ist dabei, dass wir nicht bei null anfangen müssen.
Linux besitzt seit Jahrzehnten ein ausgefeiltes Berechtigungsmodell.
Benutzer, Gruppen, Dateirechte, ACLs, Container, systemd, AppArmor oder SELinux können genutzt werden, um Prozesse voneinander zu isolieren und Zugriffe einzuschränken.
Unter Windows gibt es mit Active Directory, Service-Accounts und NTFS-ACLs ebenfalls mächtige Möglichkeiten.
Auch macOS bringt mit Unix-Berechtigungen, ACLs, Sandboxing und weiteren Sicherheitsmechanismen entsprechende Bausteine mit.
Die konkrete technische Umsetzung unterscheidet sich je nach Betriebssystem.
Das Grundprinzip bleibt aber gleich:
Die KI bekommt nicht pauschal Zugriff auf die Unternehmensumgebung. Sie bekommt genau definierte Fähigkeiten.
Aber was passiert mit Unternehmenssystemen?
Hier endet das klassische Dateirechtemodell.
Ein ERP-System funktioniert nicht wie ein Ordner auf einem Linux-Server.
Ein CRM-System funktioniert nicht wie ein lokales Dateisystem.
Und eine SaaS-Anwendung lässt sich nicht einfach über einen Service-Account und eine NTFS-ACL absichern.
Deshalb braucht eine solche Architektur zusätzlich eine Ebene oberhalb des Betriebssystems. Eine Art Policy- oder Access-Layer.
Diese Schicht könnte für jede Aktion prüfen:
Wer ist der Benutzer?
Welcher Agent möchte handeln?
Welche Daten werden benötigt?
Welche Aktion soll ausgeführt werden?
Ist diese Aktion erlaubt?
Ist eine Freigabe notwendig?
Welche technische Identität führt die Aktion aus?
Was muss protokolliert werden?
Damit entsteht eine Übersetzungsschicht zwischen der Sprache der KI und der Sprache der Unternehmens-IT.
Vielleicht brauchen wir für KI ein neues Berechtigungsmodell
Ich finde genau diese Frage momentan spannender als die Frage, welches lokale Sprachmodell man einsetzen sollte.
Denn Modelle werden austauschbarer.
Heute läuft vielleicht ein Modell von Meta, Alibaba, Mistral oder einem anderen Anbieter. Morgen ist ein anderes Modell besser.
Die grundsätzliche Frage bleibt jedoch:
Welche Fähigkeiten darf ein KI-Agent innerhalb eines Unternehmens besitzen?
Das erinnert an klassische Betriebssystemberechtigungen, geht aber darüber hinaus.
Ein KI-Agent besitzt nicht nur Zugriff auf Ressourcen. Er kann Entscheidungen treffen und daraus Aktionen ableiten.
Damit müssen wir neben der Frage „Darf dieser Prozess diese Datei lesen?“ zunehmend auch fragen:
„Darf dieser Agent diese Aktion im Namen dieses Benutzers durchführen?“
Das ist der Punkt, an dem sich klassische Berechtigungsmodelle und KI-Agenten überschneiden. Der Agent benötigt nicht nur Zugriff auf Daten, sondern klar definierte Fähigkeiten und Grenzen.
Ein möglicher Aufbau
Eine solche Architektur könnte vereinfacht aus fünf Ebenen bestehen.
Fünf Ebenen: Mensch, Identität, Policy, Agenten, Systeme
Mensch
↓
Identität
↓
Policy Layer
↓
AI-Agent Reader
AI-Agent Editor
↓
Tools / APIs / Services
↓
Files
CRM
ERP
Mail
Der Mensch bringt seine Identität und seine Unternehmensberechtigungen mit.
Der KI-Agent bringt seine eigenen Fähigkeiten und Einschränkungen mit.
Die Policy-Schicht entscheidet, ob eine konkrete Aktion unter den gegebenen Bedingungen erlaubt ist.
Die Tools führen die Aktion aus.
Die Unternehmenssysteme bleiben die eigentliche Quelle der Daten und ihrer Berechtigungen.
Das Sprachmodell selbst bleibt möglichst weit von direkten Systemrechten entfernt.
Lokale KI ist deshalb nur ein Teil der Geschichte
Für besonders sensible Anwendungen kann es sinnvoll sein, das Sprachmodell vollständig innerhalb der eigenen Infrastruktur zu betreiben.
Das kann beispielsweise mit Ollama, vLLM oder anderen lokalen Inference-Lösungen geschehen. Mehr zur Einordnung steht auf der Seite Lokale KI für Unternehmen.
Das reduziert die Abhängigkeit von externen KI-APIs und kann für bestimmte Datenklassen sinnvoll sein.
Aber „lokal“ sollte nicht mit „sicher“ gleichgesetzt werden.
Ein Modell, das lokal läuft und Zugriff auf sämtliche Unternehmensdaten besitzt, ist nicht automatisch besser abgesichert als ein Cloud-Modell.
Sicherheit entsteht durch die Kombination aus Infrastruktur, Identitäten, Berechtigungen, Isolation, Policies und nachvollziehbaren Aktionen.
Die lokale Ausführung ist dabei nur ein Baustein.
Vielleicht ist genau das der interessante Teil
Ich glaube nicht, dass jedes Unternehmen zwingend eine eigene KI-Plattform benötigt.
Und ich glaube auch nicht, dass man für jeden Kunden zwanghaft einen KI-Anwendungsfall erfinden sollte.
Interessanter ist die umgekehrte Frage:
Welche Prozesse würden Unternehmen heute gerne mit KI unterstützen, wenn sie der KI dabei vertrauen könnten?
Vielleicht ist es die interne Wissenssuche.
Vielleicht ist es die Bearbeitung von E-Mails.
Vielleicht ist es die Erstellung von Angeboten.
Vielleicht ist es die Analyse von Produktionsdaten.
Vielleicht ist es etwas völlig anderes.
Der konkrete Use Case kann sich verändern.
Die Anforderungen an Identität, Berechtigungen, Isolation und Kontrolle bleiben dagegen bestehen.
Genau deshalb könnte eine solche Sicherheits- und Zugriffsschicht langfristig interessanter sein als ein weiterer spezialisierter KI-Chatbot.
Denn die Modelle werden besser.
Die Unternehmensdaten bleiben.
Die Prozesse bleiben.
Und die Frage, was eine KI innerhalb dieser Umgebung tatsächlich darf, wird mit jedem neuen Agenten wichtiger.
Vielleicht brauchen wir also nicht mehr KI in Unternehmen. Vielleicht brauchen wir zuerst eine bessere Art, KI sicher in Unternehmen arbeiten zu lassen.
Wenn Sie prüfen möchten, welche Daten, Identitäten und Freigaben ein KI-Agent in Ihrer Umgebung tatsächlich bekommen sollte, kläre ich das in 15 Minuten unverbindlich. Zum Erstgespräch.
Jeden Morgen beginnt in vielen Unternehmen derselbe Prozess: Der aktuelle Kontoauszug wird mit den offenen Posten abgeglichen. Manche Zahlungen enthalten eine Rechnungsnummer, andere nur einen Firmennamen oder einen unvollständigen Verwendungszweck. Hinzu kommen Skonto, Teilzahlungen oder abweichende Schreibweisen zwischen Bank und ERP.
Für einen erfahrenen Mitarbeiter ist das Alltag. Für Software ist dieser Abgleich oft überraschend schwierig. Genau hier kann eine intelligente Anwendung unterstützen. Sie erkennt Zusammenhänge zwischen Zahlungseingängen und offenen Rechnungen und schlägt passende Zuordnungen vor. Der Mensch entscheidet am Ende selbst, spart sich aber einen großen Teil der manuellen Suche.
Warum der Abgleich von Zahlungseingängen so viel Zeit kostet
Ein Zahlungseingang ist selten so eindeutig, wie man es sich wünschen würde. Typische Beispiele aus der Debitorenbuchhaltung sind:
abweichende Firmennamen zwischen Bank und ERP
fehlende oder unvollständige Rechnungsnummern
Skontoabzüge
Teilzahlungen
Sammelüberweisungen für mehrere Rechnungen
Verwendungszwecke ohne verwertbare Informationen
Ein Sachbearbeiter kombiniert diese Informationen automatisch. Er erkennt, dass der Auftraggeber auf dem Kontoauszug trotz anderer Schreibweise zum Debitor im ERP gehört oder dass der Betrag aufgrund eines vereinbarten Skontos geringer ausfällt.
Genau diese Zusammenhänge lassen sich auch softwaregestützt erkennen. Anstatt jede Buchung vollständig manuell zu prüfen, werden passende Rechnungen vorgeschlagen und nur unklare Fälle zur Entscheidung vorgelegt.
Beispiel eines möglichen Workflows
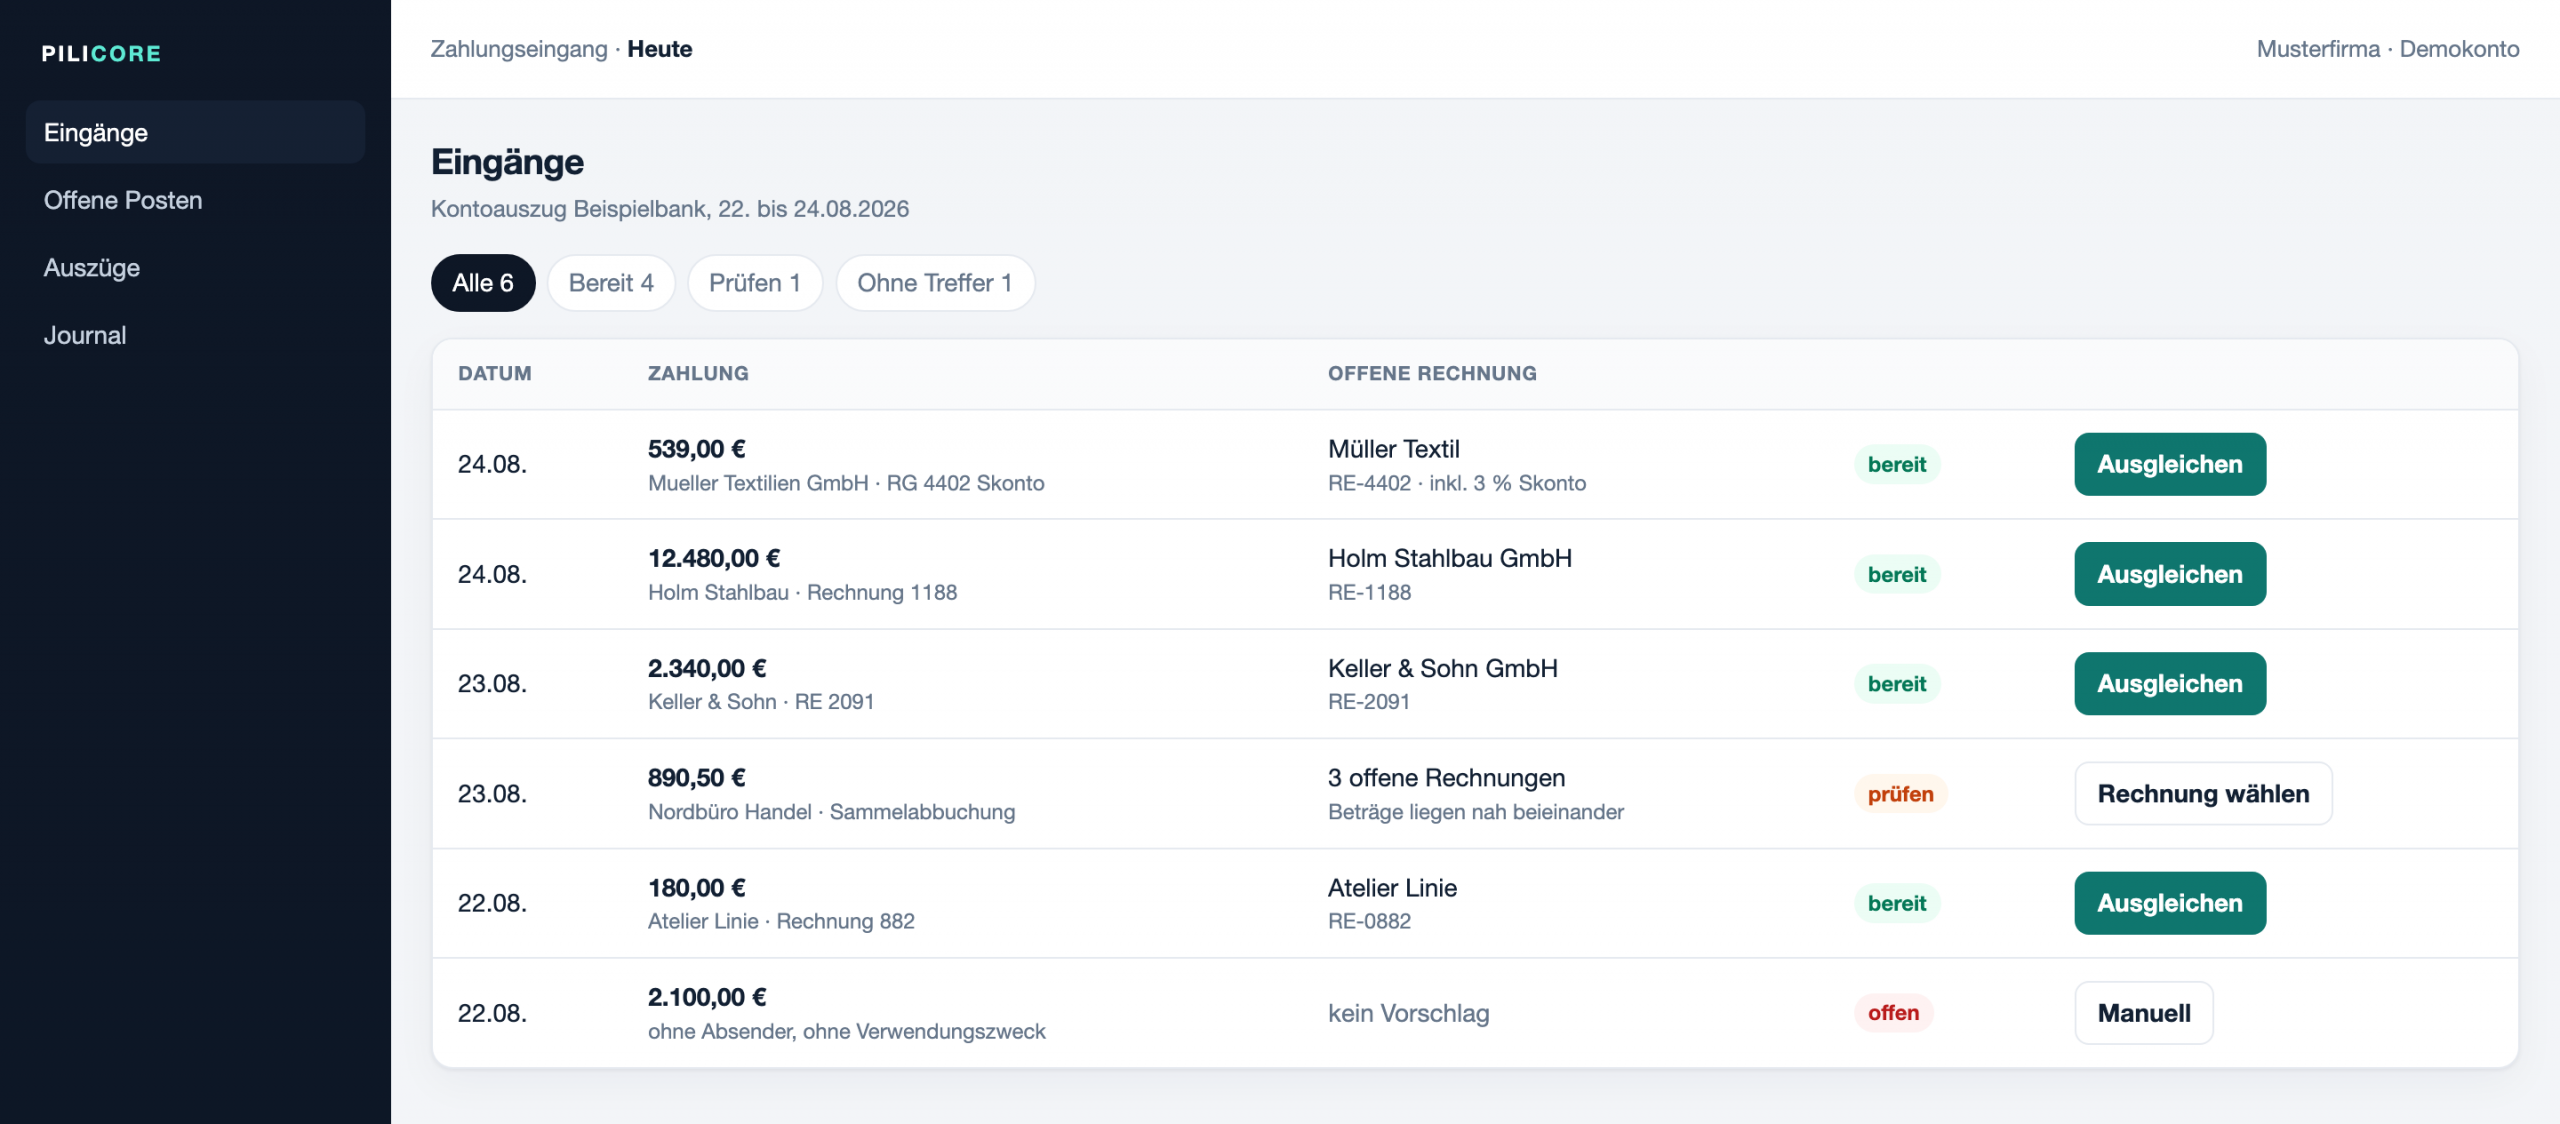
Die folgende Ansicht zeigt einen möglichen Ablauf beim Abgleich von Zahlungseingängen.
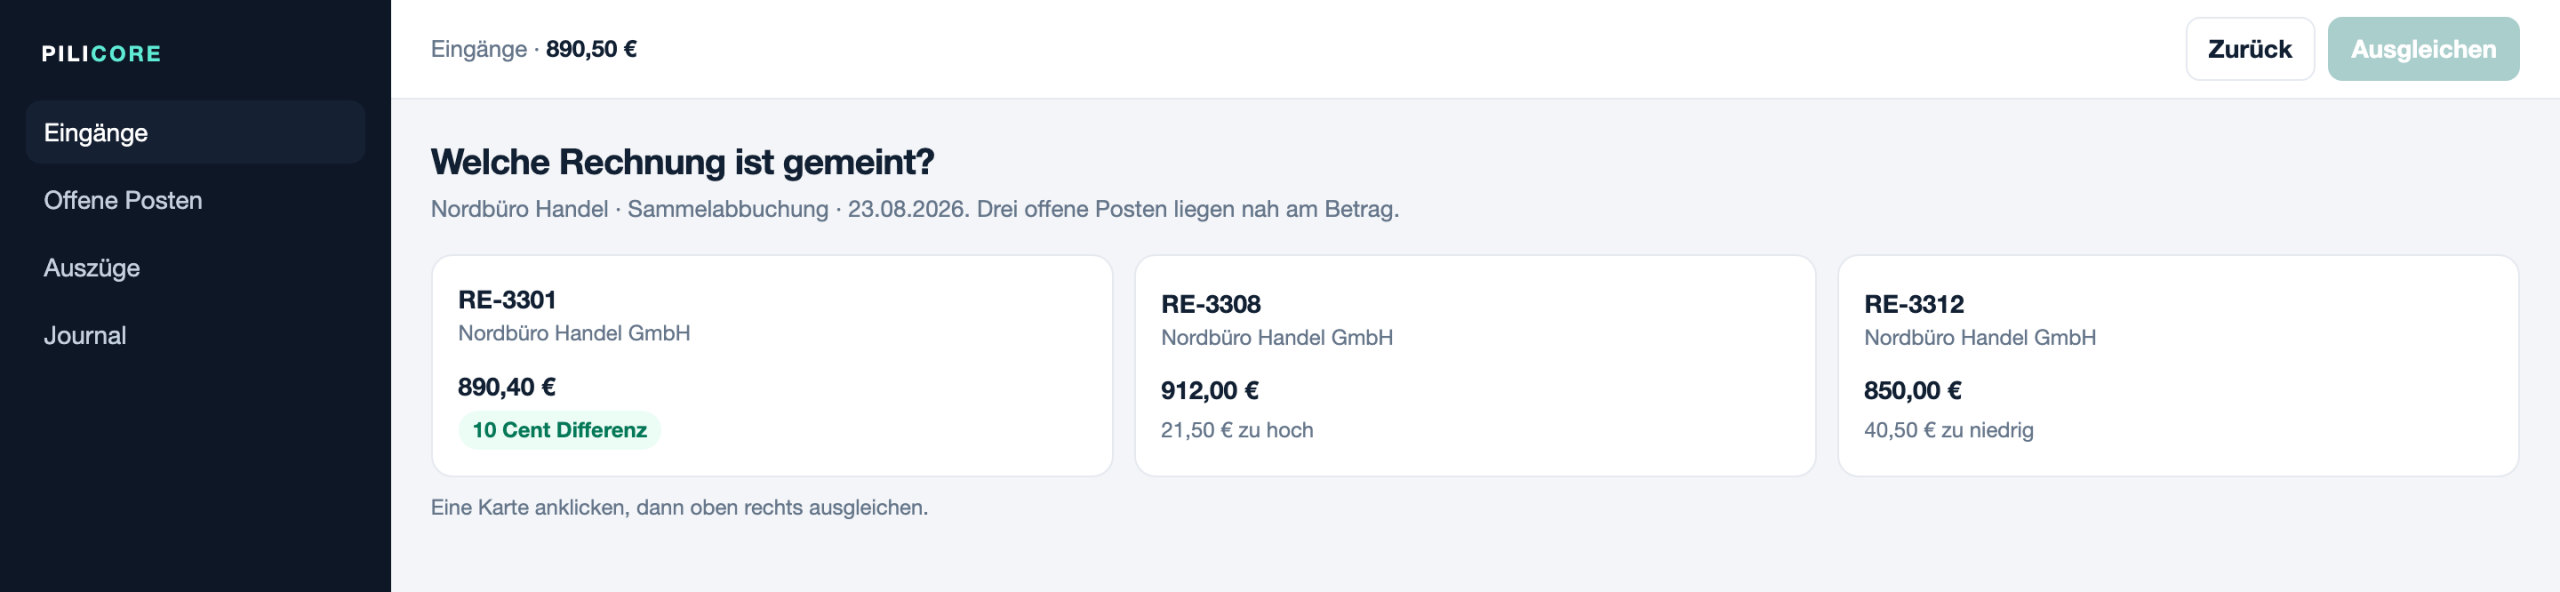
Jeder Zahlungseingang erhält einen Vorschlag. Eindeutige Treffer können direkt ausgeglichen werden. Unklare Fälle werden zur Prüfung markiert.
Für jeden Zahlungseingang wird automatisch geprüft, ob ein passender offener Posten existiert. Dabei können mehrere Kriterien gleichzeitig berücksichtigt werden:
Name des Zahlungspflichtigen
Rechnungsnummer im Verwendungszweck
Zahlungsbetrag
vereinbarte Skontoregelungen
offene Rechnungen des Debitors
Ist die Zuordnung eindeutig, kann der Zahlungseingang direkt ausgeglichen werden. Bestehen mehrere Möglichkeiten, wird der Vorgang zur manuellen Prüfung gekennzeichnet.
Abweichende Firmennamen und Skonto automatisch erkennen
Ein typischer Praxisfall zeigt, warum ein rein technischer Rechnungsabgleich oft nicht ausreicht.
Auf dem Kontoauszug steht der Auftraggeber so, wie ihn die Bank liefert:
Mueller Textilien GmbH
RG 4402
539,00 €
Im ERP steht der Debitor hingegen anders:
Müller Textil
Rechnung RE-4402
555,67 €
3 % Skonto vereinbart
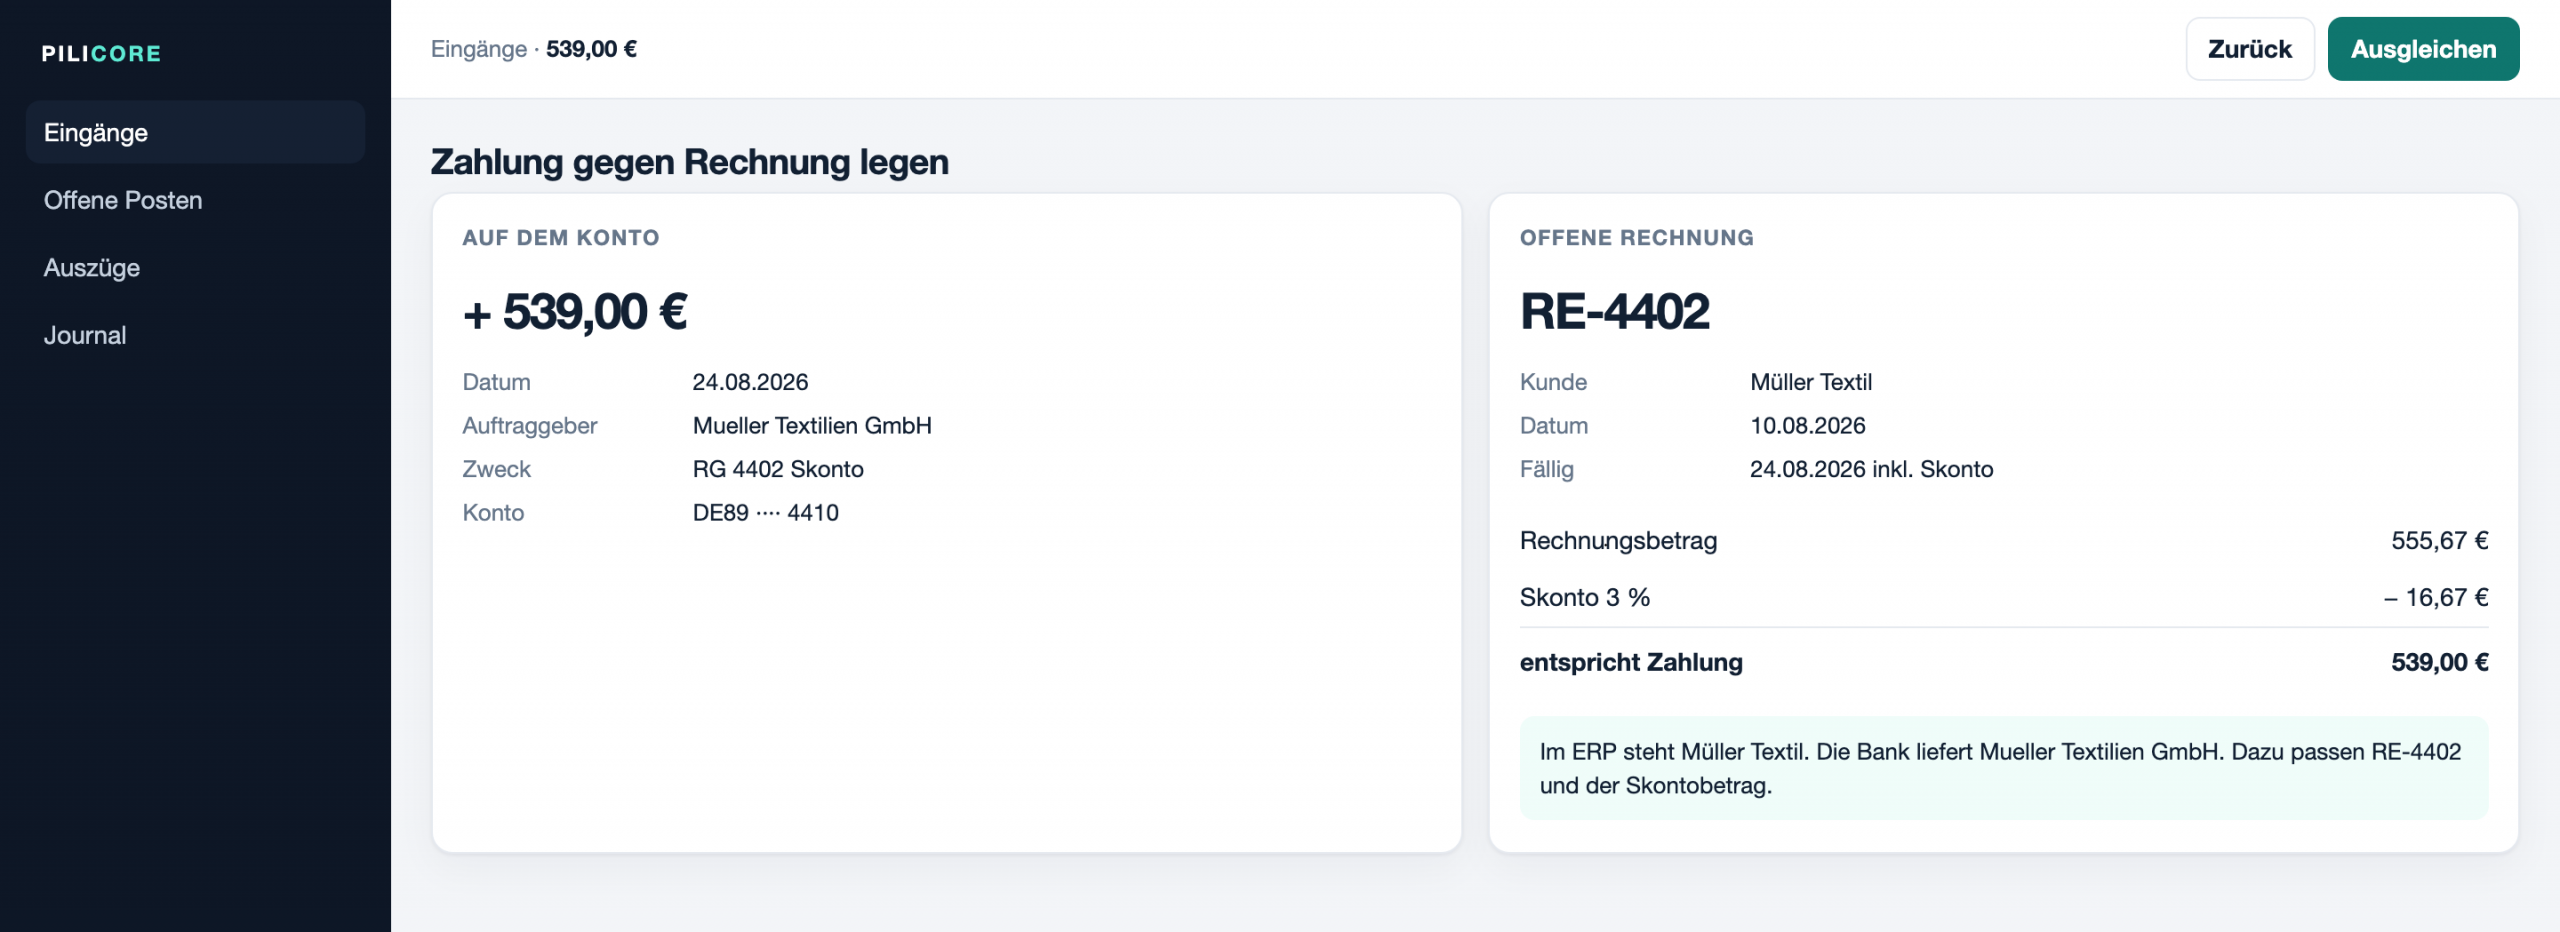
Trotz abweichender Schreibweise zwischen Bank und ERP sowie Skonto erkennt die Anwendung den passenden offenen Posten.
Für einen Mitarbeiter der Buchhaltung ist die Zuordnung offensichtlich. Die Rechnungsnummer passt, der Firmenname auf dem Auszug und im ERP meinen denselben Kunden und der Zahlungsbetrag entspricht exakt dem Rechnungsbetrag abzüglich des vereinbarten Skontos.
Eine intelligente Anwendung kann dieselben Informationen kombinieren und daraus einen eindeutigen Vorschlag erzeugen. Dadurch entfällt in vielen Fällen die manuelle Suche. Genau das ist maßgeschneiderte Prozessautomatisierung für Finanzprozesse: Regeln und Datenquellen zusammenführen, unklare Fälle dem Menschen überlassen.
Mehrdeutige Zahlungseingänge sicher bearbeiten
Nicht jeder Zahlungseingang lässt sich eindeutig zuordnen. Gerade bei Sammelüberweisungen oder mehreren offenen Rechnungen mit ähnlichen Beträgen gibt es verschiedene Möglichkeiten.
Wenn mehrere Rechnungen infrage kommen, schlägt das System passende Kandidaten vor. Die endgültige Entscheidung trifft weiterhin der Anwender.
In solchen Situationen sollte Software keine automatische Buchung durchführen. Stattdessen werden die wahrscheinlichsten Treffer angezeigt und der Sachbearbeiter entscheidet mit wenigen Klicks, welche Rechnung tatsächlich ausgeglichen werden soll.
Dieses Zusammenspiel aus Automatisierung und menschlicher Kontrolle reduziert den manuellen Aufwand erheblich, ohne die Sicherheit der Buchhaltung zu beeinträchtigen.
Die gezeigte Anwendung ist ein interaktiver Prototyp. Er veranschaulicht den späteren Arbeitsablauf und zeigt, wie Zahlungseingänge automatisiert offenen Rechnungen zugeordnet werden können. Die technische Anbindung an SAP, DATEV oder andere ERP-Systeme erfolgt erst im nächsten Schritt eines Projekts.
Für die Bewertung des Workflows ist zunächst keine direkte Verbindung zu SAP, DATEV oder einem anderen ERP-System erforderlich. Entscheidend ist die Frage, ob die Anwendung Zahlungseingänge zuverlässig erkennt, passende offene Rechnungen findet und die tägliche Arbeit in der Debitorenbuchhaltung vereinfacht.
Erst im nächsten Schritt folgt die technische Integration. Dazu gehören beispielsweise der Import von Kontoauszügen, der Zugriff auf offene Posten sowie die Übergabe der bestätigten Buchungen an das jeweilige ERP-System.
Das automatische Zuordnen von Zahlungseingängen zu offenen Rechnungen spart Zeit, reduziert manuelle Sucharbeit und unterstützt die Debitorenbuchhaltung bei täglichen Routineaufgaben. Besonders bei abweichenden Firmennamen, Skonto, Teilzahlungen oder unklaren Verwendungszwecken zeigt sich der Mehrwert intelligenter Unterstützung.
Die eigentliche Herausforderung besteht nicht darin, eine Schnittstelle zu entwickeln. Entscheidend ist ein Workflow, der Buchhaltungsmitarbeiter zuverlässig unterstützt und nur dort eingreift, wo Automatisierung wirklich sinnvoll ist.
Kennen Sie das Problem in Ihrer Debitorenbuchhaltung und möchten wiederkehrende manuelle Abgleiche reduzieren? In 15 Minuten kläre ich unverbindlich, wie sich ein solcher Workflow an Ihre bestehende Systemlandschaft anbinden lässt. Zum Erstgespräch.
Lokaler KI-Sprachassistent ohne Cloud: Erfahrungen mit einem Offline-KI-Assistenten
Die meisten KI-Assistenten leben in der Cloud. Sie hören zu, verarbeiten die Eingabe auf externen Servern und schicken die Antwort zurück. Das ist bequem und für viele Use Cases völlig ausreichend. Aber sobald vertrauliche Gespräche, Ideen, interne Dokumente oder sensibles Fachwissen ins Spiel kommen, stellt sich eine andere Frage:
Muss dieses Gespräch überhaupt das Unternehmen verlassen?
Genau deshalb habe ich Buddy gebaut: einen lokalen KI-Sprachassistenten für macOS. Kein ChatGPT im Browser. Keine API-Rechnung pro Satz. Whisper, Ollama und Kokoro laufen direkt auf dem Rechner. Die Unterhaltung bleibt dort, wo sie entsteht.
Buddy ist kein Produktpitch und kein Ersatz für Unternehmensplattformen. Es ist ein Arbeitsgerät und ein Architekturtest. Und genau deshalb eignet es sich als Praxisbeispiel: Es zeigt, was lokale KI heute schon möglich macht, wo freie Software noch an Grenzen stößt und welche Möglichkeiten entstehen, wenn Sprachmodell und Wissensquelle direkt dort laufen, wo die Daten ohnehin liegen.
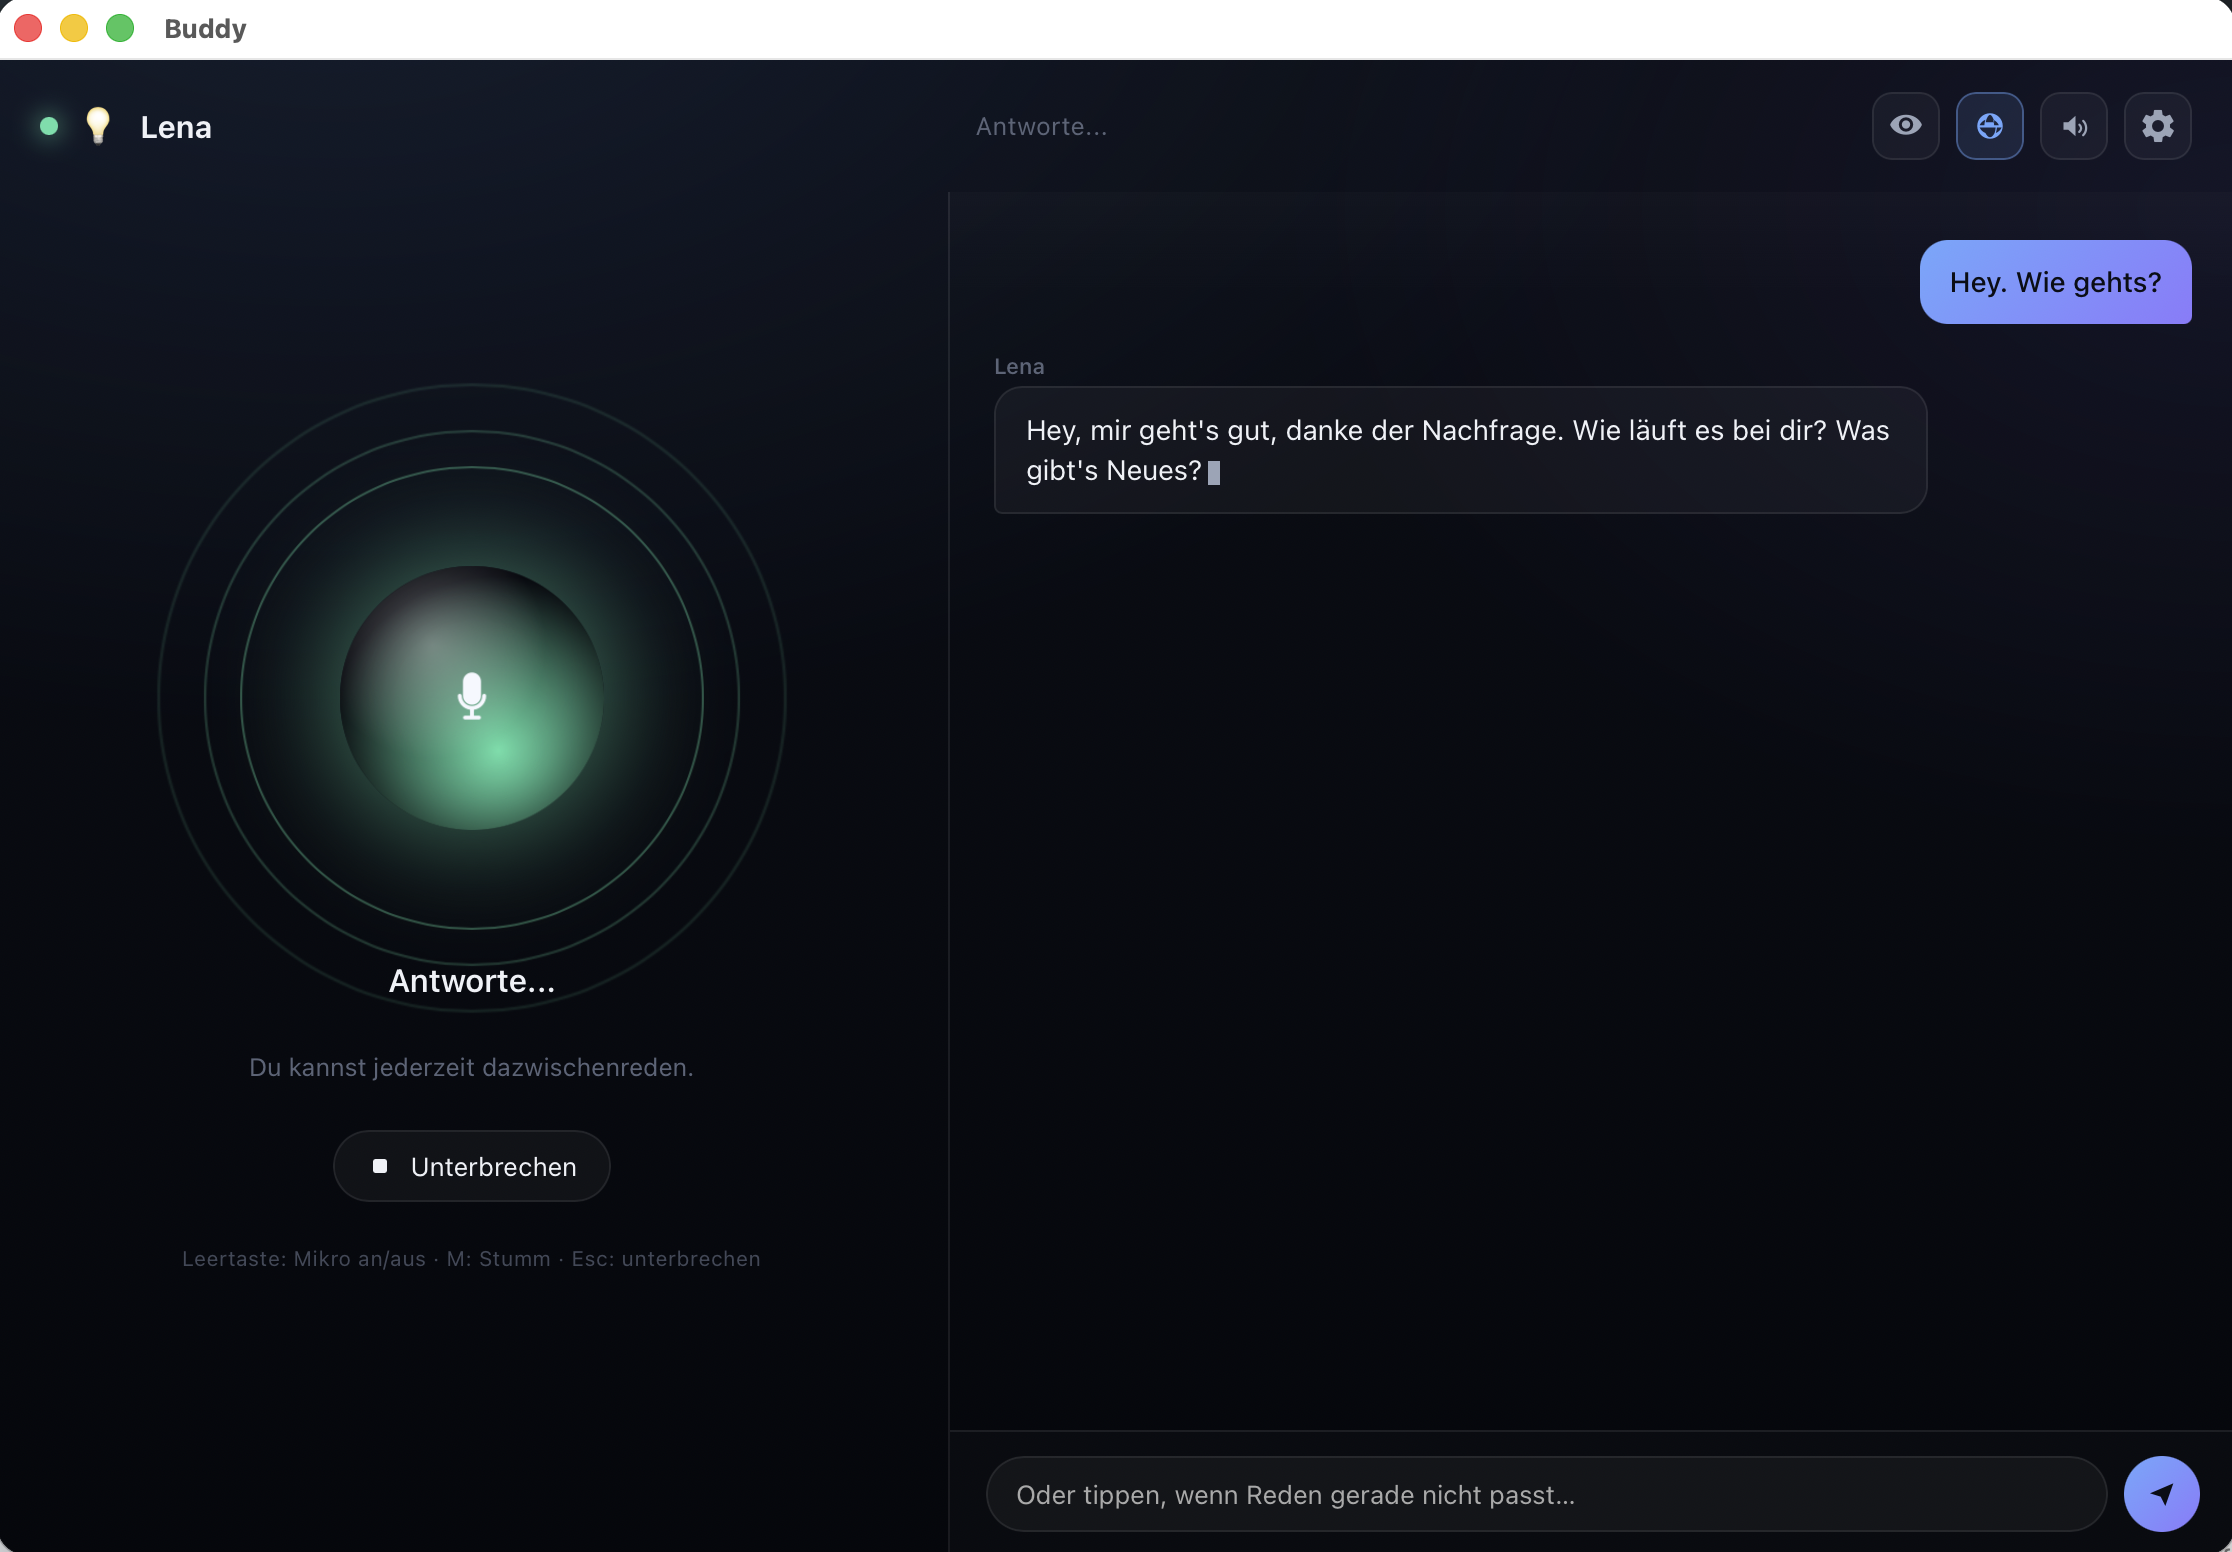
Buddy im Gespräch: Stimme und Text parallel, Antwort jederzeit abbrechbar.
Was ein lokaler KI-Sprachassistent heute kann
Buddy ist voice-first. Du redest, der Assistent hört zu, verarbeitet die Eingabe lokal und spricht zurück. Tippen geht ebenfalls, wenn Reden gerade nicht passt.
Offline-first. Spracherkennung, Sprachmodell und Stimme laufen lokal. Kein ChatGPT und keine Verarbeitung der Unterhaltung in einer Cloud.
Unterbrechen. Wenn der Assistent noch spricht, kannst du jederzeit dazwischenreden. Die Ausgabe stoppt, statt dass du den gesamten Monolog abwarten musst.
Charaktere. Lena denkt mit, Max challengt. Stimme, Stil und Persönlichkeit sind pro Charakter einstellbar.
Private Sessions. Der Incognito-Modus ermöglicht Gespräche, die nicht gespeichert werden sollen.
Optionale Recherche. Websuche gibt es nur, wenn du sie bewusst einschaltest. Standard ist die lokale Verarbeitung.
Technisch steckt dahinter ein Stack, den viele Entwickler und Teams bereits kennen: faster-whisper für Speech-to-Text, Ollama für das lokale LLM, zum Beispiel Qwen 2.5 14B oder Llama 3.2, und Kokoro für Text-to-Speech.
Die spannende Frage ist dabei nicht der Stack allein. Spannender ist, was lokal sinnvoll wird, sobald die Daten den Rechner nicht verlassen müssen.
Lokale KI statt Cloud: Wann lohnt sich das?
Cloud-Dienste sind bequem, leistungsfähig und für viele Unternehmen der richtige Weg. Trotzdem gibt es Anwendungsfälle, bei denen ein lokaler KI-Assistent deutliche Vorteile bietet.
Interne Dokumente sollen das Unternehmen nicht verlassen.
Vertrauliche Gespräche dürfen nicht an externe KI-Anbieter übertragen werden.
KI soll auch ohne Internetverbindung funktionieren.
Es gibt hohe Anforderungen an Datenschutz und Compliance.
Eigene Dokumente und Wissensquellen sollen direkt als Kontext für die KI dienen.
Bestimmte Arbeitsplätze oder Netzwerke müssen vom Internet getrennt bleiben.
Genau dort wird lokale KI interessant. Die entscheidende Frage ist nicht nur, ob ein Sprachmodell offline laufen kann. Die wichtigere Frage lautet: Was kann ein lokaler KI-Assistent mit den Daten tun, die bereits auf dem Rechner oder im eigenen Netzwerk liegen?
Ehrlicher Blick auf die Sprachqualität
Buddy klingt nicht wie ein Mensch. Und das sollte man auch nicht versprechen. Die Qualität ist gut genug für den Alltag. Aber freie Software hat Grenzen: Die Betonung bei Fragen rutscht manchmal, einzelne Buchstaben werden verschluckt und der Rhythmus bleibt gelegentlich maschinell.
Mit gezielter Optimierung geht trotzdem einiges. Chunking, Stimmenwahl, Satzlängen und Nachbearbeitung entscheiden darüber, ob die Stimme nur „okay“ oder wirklich brauchbar wirkt. Der Unterschied liegt oft nicht im großen Modellwechsel, sondern in vielen kleinen Stellschrauben.
Für Kundenprojekte ist das eine wichtige Lektion: Voice-Qualität ist Engineering, nicht Magie. Wer realistische Erwartungen setzt und systematisch nachschärft, kommt mit lokalem TTS schon weit. Wer „wie ein Mensch“ als Messlatte nimmt, wird enttäuscht.
Lena: lokale Stimme, lokales Modell und klare Verarbeitung ohne Cloud.
Der eigentliche Hebel: lokale Daten und eine lokale Wissensbasis
Stimme und Charaktere sind sichtbar. Der strategisch interessantere Punkt ist ein anderer: Ein lokaler KI-Assistent kann mit lokalen Daten arbeiten, ohne dass Fachwissen in eine externe Cloud wandert.
Daraus entstehen Use Cases, die mit einem klassischen Cloud-Chatbot oft an Grenzen stoßen oder aus Datenschutzgründen zumindest sorgfältig geprüft werden müssen:
Knowledge Base am Arbeitsplatz. Ein lokaler Assistent greift auf interne Handbücher, Prozessdokumentationen oder Projektwissen zu und unterstützt Mitarbeiter, ohne dass diese Dokumente an einen externen KI-Dienst hochgeladen werden.
Kanzlei. Ein Assistent arbeitet mit Gesetzestexten, Kommentaren und eigenen Schriftsatz-Vorlagen. Er unterstützt bei Recherche und Strukturierung, während die zugrunde liegenden Daten lokal bleiben.
Medizin und Forschung. Papers, Leitlinien und interne Notizen können als Wissensbasis dienen. Der Assistent unterstützt beim Ordnen und Nachschlagen, während sensible Daten innerhalb der eigenen Umgebung bleiben.
Fachabteilungen im Mittelstand. Normen, Verträge, Maschinenhandbücher und Qualitätsregeln sind genau die Dokumente, die man häufig nicht in einen generischen Cloud-Chat legen möchte.
Das ist der eigentliche Architekturvorteil. Nicht „schöne Stimme offline“, sondern: Modell und Wissensquelle sitzen dort, wo die Daten sowieso liegen dürfen. Aus einem Chatbot wird ein lokaler KI-Agent mit echtem Kontext.
Technisch heißt das typischerweise Retrieval über lokale Dokumente, klare Zugriffsrechte und eine definierte Systemprompt-Rolle. Buddy zeigt den Einstieg. In Kundenprojekten wird daraus eine belastbare KI-Wissensdatenbank: Wissensindex, Auswertungspfad und Auditierbarkeit, lokal hinter der Firewall oder in einer EU-Cloud. Die Daten bleiben in der gewählten Umgebung. Es entsteht kein Vendor-Lock-in bei einem öffentlichen Chatbot.
Max: Rolle und Prompt sind einstellbar. Der nächste Schritt ist lokaler Fachkontext.
Charaktere und Unterbrechen bleiben nützlich
Die meisten KI-Chats klingen gleich: höflich, glatt und austauschbar. In Buddy ist der Charakter Teil der Architektur. Lena denkt mit. Max challengt, statt alles abzunicken.
Das ist kein Selbstzweck. In echten Arbeitskontexten braucht man unterschiedliche Modi: nachfragen, kritisch hinterfragen, schnell entscheiden oder gründlich erklären. Rolle und Prompt steuern das klarer als ein generischer „Hilf mir“-Chat.
Unterbrechen gehört dazu. Viele Voice-Demos zwingen dich, bis zum Ende zuzuhören. In Buddy kannst du die Ausgabe abbrechen und direkt neu ansetzen. Das ist kein menschlicher Dialog. Es ist aber ein wichtiger Unterschied zwischen einem Werkzeug und einer Monolog-Maschine.
Gerade in Betrieb, Lager, Service oder anderen Situationen, in denen Mitarbeiter nicht ständig auf einen Bildschirm schauen können, entscheiden solche Details darüber, ob ein Sprachassistent tatsächlich im Alltag funktioniert.
Was lokale KI für Unternehmen interessant macht
Buddy selbst ist ein persönliches Lab. Die Erkenntnisse daraus lassen sich trotzdem direkt auf Unternehmensprojekte übertragen:
Nicht jede KI braucht die Cloud. Gerade dann nicht, wenn Fachdaten, Entwürfe oder interne Gespräche innerhalb der eigenen Umgebung bleiben sollen.
Datenschutz beginnt bei der Architektur. „Wir haben einen Auftragsverarbeiter“ ist etwas anderes als „die Daten verlassen den Rechner nicht“.
Lokale Agenten werden mit lokalen Quellen interessant. Gesetzestexte, Papers, Handbücher, Normen und interne Wissensbasen schaffen den eigentlichen Mehrwert.
Qualität ist Optimierungsarbeit. Stimme, Retrieval und Rollenprompt werden durch Nachschärfen brauchbar und nicht durch einmaliges Aufsetzen.
Genau so arbeite ich bei Pilicore: Erst kommt das Prozessproblem, dann die passende Architektur. Manchmal ist das Microsoft Copilot. Manchmal eine eigene Agentenplattform. Manchmal ein lokales Modell mit eigener Wissensbasis hinter der Firewall.
Die richtige Antwort kommt selten aus dem Marketing-Slide, sondern aus dem gebauten Prototyp. Gerade bei lokaler KI lässt sich dadurch schnell herausfinden, ob ein Modell, eine Hardwarekonfiguration und eine bestimmte Wissensbasis für den konkreten Anwendungsfall bereits ausreichen.
Für wen sich ein lokaler KI-Sprachassistent lohnt
Ein lokaler KI-Assistent lohnt sich besonders, wenn mindestens eines dieser Kriterien zutrifft:
Fachdaten oder vertrauliche Gespräche dürfen nicht in externe Clouds gelangen.
Sie wollen KI offline oder mit strenger Netztrennung nutzen.
Sie brauchen einen KI-Agenten auf eigenen Dokumenten, zum Beispiel für eine Knowledge Base, Normen oder Papers.
Sie möchten testen, ob lokale Sprachmodelle für Ihren konkreten Use Case bereits ausreichen.
Sie wollen sensible Unternehmensdaten mit KI nutzen, ohne dafür einen externen KI-Dienst als zentrale Datenverarbeitungsstelle einzusetzen.
Er lohnt sich weniger, wenn Sie vor allem breite Webrecherche, umfangreiche Office-Integration für die gesamte Belegschaft oder unternehmensweite Workflows benötigen. Dann sind Cloud-Assistenten oder integrierte Plattformen häufig der kürzere und wirtschaftlichere Weg.
Lokale KI oder Cloud-KI: Was ist die bessere Lösung?
Die Frage sollte deshalb nicht lauten, ob lokale KI grundsätzlich besser ist als Cloud-KI. Die bessere Frage lautet: Welche Architektur passt zum konkreten Prozess, zu den Daten und zu den Anforderungen des Unternehmens?
Cloud-KI bietet große Modelle, einfache Skalierung und eine schnelle Integration in bestehende Plattformen. Lokale KI bietet dagegen mehr Kontrolle über Daten, Modelle und die technische Umgebung.
In der Praxis kann deshalb auch eine Kombination sinnvoll sein. Ein Unternehmen kann beispielsweise allgemeine Aufgaben mit einem Cloud-Assistenten erledigen und besonders sensible Dokumente oder Prozesse mit einem lokalen Modell verarbeiten.
Entscheidend ist, die Architektur nicht nach dem aktuellen KI-Hype auszuwählen, sondern nach dem tatsächlichen Anwendungsfall.
Häufige Fragen zu lokalen KI-Assistenten
Kann man einen KI-Assistenten komplett ohne Cloud betreiben?
Ja. Mit Komponenten wie faster-whisper für Speech-to-Text, Ollama für lokale Sprachmodelle und Kokoro für Text-to-Speech lässt sich ein Sprachassistent vollständig lokal betreiben. Voraussetzung ist natürlich, dass die verwendeten Modelle und Anwendungen lokal installiert sind und keine externen Dienste für einzelne Funktionen benötigen.
Ist ein lokaler KI-Assistent automatisch DSGVO-konform?
Nein. Lokale Verarbeitung kann Datenschutz und Compliance deutlich vereinfachen, weil Daten nicht automatisch an externe Anbieter übertragen werden. Ein lokales System muss trotzdem sauber konfiguriert, abgesichert und in das Datenschutzkonzept des Unternehmens eingebunden werden.
Welche Modelle kann man lokal mit Ollama betreiben?
Ollama unterstützt eine Vielzahl lokaler Sprachmodelle. Welche Variante sinnvoll ist, hängt vom Anwendungsfall, der verfügbaren Hardware und den Anforderungen an Geschwindigkeit und Antwortqualität ab. Für einen produktiven Einsatz sollte deshalb nicht nur das größte verfügbare Modell betrachtet werden.
Welche Hardware braucht ein lokaler KI-Assistent?
Das hängt stark vom verwendeten Modell ab. Moderne Macs mit Apple Silicon und leistungsfähige PCs können bereits viele aktuelle Sprachmodelle lokal ausführen. Für größere Modelle und mehrere parallele Benutzer steigen die Anforderungen entsprechend.
Lohnt sich lokale KI für den Mittelstand?
Ja, insbesondere wenn sensible Unternehmensdaten, interne Dokumente oder Fachwissen mit KI verarbeitet werden sollen. Entscheidend ist aber immer der konkrete Prozess. Nicht jede Aufgabe benötigt ein lokales Modell und nicht jede Cloud-Anwendung lässt sich sinnvoll durch lokale KI ersetzen.
Was Buddy am Ende zeigt
Buddy ist kein Beweis dafür, dass lokale KI die Cloud ersetzt. Das wäre genauso falsch wie die Behauptung, dass Cloud-KI für jedes Unternehmen die beste Lösung ist.
Buddy zeigt etwas viel Interessanteres: Ein lokaler KI-Sprachassistent ist heute technisch machbar und für bestimmte Anwendungsfälle bereits erstaunlich brauchbar.
Die spannendste Entwicklung liegt dabei nicht unbedingt in der Stimme. Sie liegt darin, dass Sprachmodell, Assistent und Wissensbasis gemeinsam in einer kontrollierten Umgebung arbeiten können.
Aus einem einfachen Sprachassistenten kann dadurch ein lokaler KI-Agent werden, der nicht nur Fragen beantwortet, sondern mit dem Wissen eines Unternehmens arbeitet.
Genau dort wird lokale KI für Unternehmen interessant.
Wenn Sie prüfen möchten, ob ein lokales KI-Modell, ein eigener KI-Agent oder eine hybride Architektur für Ihren Anwendungsfall sinnvoll ist, lohnt sich zuerst ein konkreter Prototyp. Nicht jede KI-Frage braucht ein großes Projekt. Oft zeigt ein kleiner Proof of Concept schneller, welche Architektur tatsächlich funktioniert.
Möchten Sie generative KI oder Sprach- und Textassistenten im Unternehmen nutzen, scheitern aber an den Datenschutzvorgaben der Cloud? In 15 Minuten kläre ich unverbindlich, wie eine lokale oder EU-Cloud-Architektur für Ihre internen Daten aussehen kann. Zum Erstgespräch.
IT-Sicherheit bei Softwareprojekten: Was Auftraggeber von Dienstleistern erwarten sollten
Eine Frage sollte jeder Auftraggeber vor dem Start eines IT-Projekts stellen: Wie stellt der Dienstleister sicher, dass das System auch in Zukunft sicher und wartbar bleibt?
Diese Frage trennt saubere Projektarbeit von kurzfristiger Umsetzung. Denn viele Softwarelösungen funktionieren beim Go-Live gut. Die eigentlichen Herausforderungen kommen später: Updates werden aufgeschoben, Abhängigkeiten veralten, Zuständigkeiten sind unklar und bekannte Sicherheitslücken bleiben offen, bis ihre Behebung teuer oder dringend wird.
IT-Sicherheit ist deshalb keine Aufgabe, die mit dem Projektabschluss erledigt ist. Ein System bleibt nur dann belastbar, wenn Sicherheit, Wartung und Updates von Anfang an Teil der Projektlogik sind.
Ich stelle mir diese Frage auch intern konsequent. Wenn die eigene Entwicklungsumgebung nicht gepflegt wird, entstehen dort dieselben technischen und sicherheitsrelevanten Risiken, die später beim Kunden zum Problem werden können.
Warum IT-Sicherheit keine Einmalaufgabe ist
In vielen IT-Projekten liegt der Fokus auf Delivery. Der Termin muss gehalten werden, die Features müssen funktionieren und das Team arbeitet nach dem Go-Live bereits am nächsten Thema. Genau dabei entsteht eine gefährliche Lücke zwischen Entwicklung, Auslieferung und dauerhaftem Betrieb.
Software verändert sich ständig. Betriebssysteme erhalten Updates, Bibliotheken werden aktualisiert, neue Sicherheitslücken werden veröffentlicht und Abhängigkeiten ändern sich. Eine Anwendung, die heute sicher betrieben werden kann, braucht deshalb auch morgen Aufmerksamkeit.
Typische Probleme sehe ich in unterschiedlichen Umgebungen, unabhängig davon, ob macOS, Windows oder Linux eingesetzt wird:
Veraltete Bibliotheken mit bekannten Schwachstellen
Fehlende Routinen für Security Checks und Dependency Checks
Keine klaren Verantwortlichen für Updates und Freigaben
Technische Schulden, die durch Zeitdruck immer weiter verschoben werden
Unklare Dokumentation darüber, warum Risiken akzeptiert oder geschlossen wurden
Fehlende regelmäßige Überprüfung von Entwicklungs- und Produktionsumgebungen
Das ist kein rein technisches Detail. Es ist ein Geschäftsrisiko. Ein Sicherheitsvorfall kann den Betrieb beeinträchtigen, Kosten verursachen, die Reputation beschädigen und je nach Branche zusätzliche regulatorische Pflichten auslösen.
Was Auftraggeber von einem professionellen IT-Dienstleister erwarten sollten
Gute Dienstleister beantworten die Frage nach IT-Sicherheit nicht mit allgemeinen Aussagen wie „Wir achten darauf“. Sie können erklären, welche Sicherheits- und Wartungsroutinen eingesetzt werden, wer dafür verantwortlich ist und wie offene Risiken behandelt werden.
Diese Punkte sollten Auftraggeber konkret einfordern:
Fester Wartungsrhythmus. Es gibt definierte Intervalle für Dependency Checks, Security Patches und Plattform Updates.
Klare Verantwortlichkeiten. Eine Person oder Rolle ist benannt, priorisiert Risiken und steuert die Umsetzung.
Risikobasierte Priorisierung. Kritische Schwachstellen werden schnell behandelt. Weniger kritische Themen werden mit klarer Frist eingeplant.
Nachvollziehbare Dokumentation. Änderungen, offene Risiken und Entscheidungen werden transparent festgehalten.
Regelmäßige Reviews. Sicherheit, Wartbarkeit und technische Schulden werden strukturiert überprüft und nicht nur dann betrachtet, wenn bereits ein Problem entstanden ist.
Fehlt einer dieser Punkte, ist das zumindest ein Warnsignal. Dann besteht die Gefahr, dass sich technische Schulden und Sicherheitsrisiken über Monate oder Jahre aufbauen.
Wartung beginnt bereits bei der Architektur
Eine gute Wartungsroutine kann nicht erst nach dem Go-Live beginnen. Schon bei der Entwicklung sollte darauf geachtet werden, dass Komponenten aktualisierbar sind, Abhängigkeiten nachvollziehbar bleiben und Sicherheitsprüfungen in den Entwicklungsprozess integriert werden können.
Das betrifft nicht nur den eigentlichen Anwendungscode. Auch Frameworks, Libraries, Container, Betriebssysteme, Build Tools und externe Schnittstellen gehören zur technischen Gesamtumgebung.
Je transparenter diese Abhängigkeiten sind, desto einfacher lassen sich spätere Updates planen. Wer dagegen eine Anwendung mit vielen unbekannten oder veralteten Komponenten übernimmt, bezahlt häufig später für technische Schulden, die während der Entwicklung entstanden sind.
Mein Ansatz: Wartung als Teil der Projektlogik
Ich behandle Wartung nicht als Nachgedanken, sondern als Bestandteil von Architektur und Delivery. Das Ziel ist einfach: Risiken früh sichtbar machen und in überschaubaren Zyklen bearbeiten.
1. Basis-Check zu Beginn
Zum Projektstart erfasse ich den Ist-Zustand der Umgebung. Welche Komponenten laufen? Welche Versionen sind im Einsatz? Welche Abhängigkeiten sind kritisch? Welche Updates sind bereits überfällig?
So entsteht eine belastbare Ausgangsbasis statt eines Bauchgefühls. Gerade bei bestehenden Systemen ist dieser Schritt wichtig, weil technische Risiken sonst oft erst während eines späteren Projekts sichtbar werden.
2. Wartungsroutine mit festen Intervallen
Ich definiere direkt einen klaren Rhythmus für Prüfungen und Updates. Dazu gehören beispielsweise Security Scans, Dependency Reviews, Betriebssystem Updates und die Überprüfung relevanter Plattformkomponenten.
Der genaue Rhythmus richtet sich nach Risiko und Systemkritikalität. Eine geschäftskritische Anwendung braucht eine andere Wartungsroutine als ein internes Hilfswerkzeug.
3. Verantwortlichkeit und Eskalation
Jede Wartungsaufgabe braucht einen Owner. Offene Risiken werden nicht nur gesammelt, sondern mit Frist und Entscheidung versehen.
Wenn ein kritischer Punkt nicht sofort geschlossen werden kann, sollte dokumentiert sein, wer das Risiko bewertet, welche Übergangslösung gilt und wann die endgültige Behebung erfolgen soll.
4. Transparenter Wartungsreport
Auftraggeber erhalten regelmäßige Statusberichte mit drei einfachen Fragen: Was wurde geschlossen? Was ist noch offen? Welche Auswirkungen hat das auf das Risiko?
Damit wird Wartung steuerbar und überprüfbar. Gleichzeitig entsteht eine nachvollziehbare Grundlage für Gespräche mit IT, Geschäftsführung, Datenschutz oder gegebenenfalls Auditoren.
Security Updates sind Teil des normalen Betriebs
Ein häufiger Fehler ist, Sicherheitsupdates als Ausnahme zu behandeln. In einer professionell betriebenen Softwareumgebung gehören sie zum normalen Lebenszyklus.
Natürlich kann ein Update nicht immer sofort eingespielt werden. Abhängigkeiten müssen getestet werden, produktive Systeme dürfen nicht unnötig ausfallen und manche Änderungen benötigen eine Freigabe.
Entscheidend ist deshalb nicht, dass jedes Update innerhalb von Stunden installiert wird. Entscheidend ist, dass es einen definierten Prozess gibt, mit dem neue Schwachstellen bewertet, priorisiert, getestet und nachvollziehbar geschlossen werden.
Ergebnis: Mehr Sicherheit und planbarer Betrieb
Wenn Wartungs- und Sicherheitsroutinen sauber umgesetzt werden, entsteht ein klarer betrieblicher Vorteil:
Weniger kritische Sicherheitslücken im laufenden Betrieb
Weniger ungeplante Notfalleinsätze
Schnellere Reaktion auf neue Schwachstellen
Bessere Nachvollziehbarkeit für Audits und Compliance
Weniger technische Schulden
Planbarere Kosten statt teurer Ad-hoc-Maßnahmen
Das macht den Unterschied zwischen einem Projekt, das nur erfolgreich startet, und einem System, das auch langfristig zuverlässig betrieben und weiterentwickelt werden kann.
Ein häufiger Fall aus Mittelstandsprojekten ist die automatisierte Verarbeitung von Dokumenten. Zum Go-Live funktioniert der Prozess: Rechnungen, Bestellungen oder Schadendokumente werden erkannt, relevante Informationen extrahiert und an die nächste Station weitergegeben.
Ohne Wartungsroutine kann die Qualität jedoch mit der Zeit sinken. Neue Dokumententypen kommen hinzu, Bibliotheken ändern sich, Datenformate variieren und externe Schnittstellen werden angepasst.
Mit einer sauberen Wartungsroutine bleibt der Prozess stabil. Modelle und Abhängigkeiten werden überprüft, Regeln werden angepasst, neue Dokumenttypen werden berücksichtigt und Ausnahmen werden dokumentiert.
Das Ergebnis ist nicht nur technische Stabilität. Es geht vor allem um verlässliche Prozessqualität für die Fachabteilung.
Was Sie als Auftraggeber vor dem Projektstart prüfen sollten
Wenn Sie aktuell mit einem IT-Dienstleister arbeiten oder ein neues Softwareprojekt planen, prüfen Sie diese Fragen:
Gibt es einen dokumentierten Wartungsplan mit festen Intervallen?
Sind Verantwortliche für Sicherheitsupdates eindeutig benannt?
Werden Abhängigkeiten regelmäßig auf bekannte Schwachstellen geprüft?
Gibt es einen definierten Prozess für kritische Sicherheitslücken?
Werden offene Risiken und technische Schulden transparent dokumentiert?
Ist geregelt, wie Updates getestet und in die produktive Umgebung übernommen werden?
Wenn Sie hier mehrfach mit „Nein“ antworten, ist das kein nebensächliches Detail. Es ist ein konkreter Hinweis darauf, dass Wartung und IT-Sicherheit im Projekt stärker verankert werden sollten.
Fazit: Eine sichere Softwarelösung braucht kontinuierliche Pflege
IT-Sicherheit entsteht nicht dadurch, dass ein System einmal sicher entwickelt und anschließend sich selbst überlassen wird. Software ist ein laufendes System. Abhängigkeiten ändern sich, neue Schwachstellen werden bekannt und Anforderungen entwickeln sich weiter.
Professionelle Softwareentwicklung endet deshalb nicht mit dem Go-Live. Wartungsroutinen, Security Checks, Updates und klare Verantwortlichkeiten gehören genauso zum Projekt wie Architektur, Entwicklung und Testing.
Genau das sollten Auftraggeber von einem professionellen IT-Dienstleister erwarten können: nicht das Versprechen, dass ein System für immer sicher ist, sondern einen nachvollziehbaren Prozess, mit dem Sicherheit und Wartbarkeit dauerhaft im Blick bleiben.
Bei Pilicore denke ich deshalb nicht nur bis zum Go-Live. Ich baue Systeme so, dass sie auch danach gewartet, geprüft und weiterentwickelt werden können.
Microsoft Copilot vs. eigene KI-Lösung: Welche Lösung passt zu Ihrem Unternehmen?
Microsoft Copilot ist inzwischen in vielen IT-Abteilungen angekommen. Die Versprechen klingen überzeugend: KI direkt in Word, Excel, Teams und Outlook. Keine eigene Infrastruktur, wenig Entwicklungsaufwand und ein schneller Einstieg für viele Mitarbeiter.
Trotzdem höre ich von IT-Leitern und Geschäftsführern immer wieder dieselbe Frage: „Reicht uns Microsoft Copilot, oder brauchen wir eine eigene KI-Lösung?“
Die ehrliche Antwort: Es kommt darauf an. Und zwar auf sehr konkrete Dinge: Wo liegen Ihre Daten? Welche Prozesse sollen verbessert werden? Wie sensibel sind die Informationen? Und wie viel individuelle Logik braucht der Anwendungsfall?
Microsoft Copilot und eine eigene KI-Lösung sind deshalb keine direkten Gegenspieler. Sie lösen unterschiedliche Probleme. Die entscheidende Frage ist nicht, welche Technologie besser ist, sondern welche Lösung zum jeweiligen Geschäftsprozess passt.
Was Microsoft Copilot gut kann
Microsoft Copilot ist besonders stark bei Aufgaben, die direkt in Microsoft 365 stattfinden. Wer bereits mit Word, Excel, Teams, Outlook und PowerPoint arbeitet, bekommt KI-Unterstützung dort, wo die tägliche Arbeit ohnehin stattfindet.
E-Mail-Entwürfe und Zusammenfassungen in Outlook
Meeting-Zusammenfassungen und Gesprächsvorbereitung in Teams
Präsentationen aus Stichpunkten in PowerPoint
Analysen und Unterstützung bei Tabellen in Excel
Zusammenfassungen und Textarbeit in Word
Das funktioniert schnell und ohne eigenes KI-Entwicklungsprojekt. Für viele Büroaufgaben kann Copilot deshalb einen echten Produktivitätsgewinn bringen.
Wenn ein Unternehmen hauptsächlich Microsoft 365 nutzt und generische Aufgaben im Büro beschleunigen möchte, ist Copilot häufig der sinnvollste erste Schritt. Man muss nicht für jede KI-Anforderung eine eigene Software entwickeln.
Wo Microsoft Copilot an Grenzen kommt
Interessant wird die Entscheidung, sobald die Anforderungen über klassische Büroarbeit hinausgehen. Denn viele Unternehmen haben ihre wichtigsten Informationen und Prozesse längst nicht ausschließlich in Microsoft 365.
Eigene Datenquellen. Was passiert mit Informationen aus ERP, CRM, DMS, Fachanwendungen oder Datenbanken? Microsoft bietet verschiedene Möglichkeiten, weitere Datenquellen anzubinden und Copilot zu erweitern. Copilot kennt SharePoint und Mails gut. Sobald Unternehmenswissen aus ERP, altem DMS oder Fachanwendungen dazukommt, ist eine individuelle Wissensdatenbank oft der passendere Weg.
Spezifische Prozesse. Copilot kann eine E-Mail zusammenfassen. Aber was passiert, wenn eine eingehende Rechnung gegen eine Bestellung geprüft, mit einem Lieferschein abgeglichen, bei Abweichungen markiert und anschließend an die richtige Stelle weitergeleitet werden soll? Oder wenn eine Schadenmeldung klassifiziert, auf Vollständigkeit geprüft und anschließend in ein Fachsystem übernommen werden muss?
Solche Prozesse bestehen aus mehreren Schritten, Regeln, Datenquellen und Entscheidungen. Dafür reicht ein allgemeiner KI-Assistent häufig nicht aus. Hier braucht es individuelle Prozessautomatisierung: KI dort, wo unstrukturierte Daten ankommen, klassische Integration dort, wo Regeln reichen.
Datenschutz und Compliance. Auch die Frage nach der Datenverarbeitung muss zum Anwendungsfall passen. Microsoft Copilot arbeitet innerhalb der Microsoft-Cloud und bringt entsprechende Sicherheits- und Compliance-Funktionen mit. Das kann für viele Unternehmen ausreichend sein. Bei besonders sensiblen Daten oder strengen regulatorischen Anforderungen kann jedoch eine andere Architektur notwendig sein, etwa eine eigene Cloud-Umgebung, eine abgeschottete Infrastruktur oder ein lokal betriebenes Modell.
Wichtig ist dabei: Eine eigene KI-Lösung ist nicht automatisch datenschutzfreundlicher. Entscheidend ist, wo Daten verarbeitet werden, welche Anbieter beteiligt sind, welche Zugriffsrechte bestehen und wie die gesamte Architektur abgesichert ist.
Kosten und Nutzerzahl. Bei Copilot entstehen in der Regel nutzerbezogene Lizenzkosten. Bei einer größeren Belegschaft kann deshalb die Frage entstehen, ob tatsächlich jeder Mitarbeiter einen eigenen Copilot-Zugang benötigt oder ob eine individuelle KI-Lösung für einen bestimmten Prozess wirtschaftlicher ist.
Umgekehrt darf man bei einer eigenen Lösung die Entwicklungs-, Betriebs- und Wartungskosten nicht unterschätzen. Eine faire Kostenbetrachtung muss deshalb immer den gesamten Lebenszyklus berücksichtigen.
Was eine individuelle KI-Lösung bietet
Eine maßgeschneiderte KI-Lösung ist kein Ersatz für Microsoft Copilot. Sie löst ein anderes Problem. Während Copilot die allgemeine Produktivität innerhalb der Microsoft-Welt steigert, kann eine individuelle Lösung gezielt einen bestimmten Geschäftsprozess automatisieren oder einen KI-Agenten für eine konkrete Aufgabe bereitstellen.
Zugriff auf mehrere Datenquellen. Eine individuelle Lösung kann Daten aus SharePoint, ERP, CRM, DMS, Datenbanken und APIs in einem Prozess zusammenführen. Dadurch entsteht ein unternehmensspezifischer Kontext, der weit über ein einzelnes Dokument oder eine einzelne Anwendung hinausgehen kann.
Prozessverständnis. Sie definieren die Regeln. Welche Dokumente gehören zusammen? Welche Prüfschritte sind notwendig? Welche Informationen müssen extrahiert werden? Wann darf automatisch entschieden werden? Wann muss ein Mitarbeiter freigeben?
Die KI wird dadurch Teil eines konkreten Geschäftsprozesses und nicht nur ein allgemeiner Assistent.
Kontrolle über Daten und Architektur. Bei einer eigenen Lösung können Sie festlegen, wo Daten verarbeitet werden und welche Modelle zum Einsatz kommen. Je nach Anforderung kann das eine Cloud-Infrastruktur, eine abgeschottete Umgebung, ein eigener Server oder auch ein lokal betriebenes Modell sein.
Individuelle Integration. Ein eigener KI-Agent kann nicht nur Antworten erzeugen. Er kann Informationen aus bestehenden Systemen abrufen, Dokumente analysieren, Daten strukturieren und anschließend definierte Aktionen auslösen. Genau hier entsteht häufig der größere wirtschaftliche Nutzen.
Copilot oder eigene KI-Lösung: Die Entscheidungshilfe
Nicht jedes Unternehmen braucht eine eigene KI-Lösung. Und nicht jedes Unternehmen kommt mit Copilot allein aus. Diese Fragen helfen bei der ersten Einordnung:
Wo liegen die wichtigsten Daten?
Copilot reicht oft: Die relevanten Informationen liegen überwiegend in Microsoft 365 Eigene Lösung interessant: Daten müssen aus ERP, CRM, DMS, Datenbanken oder Fachanwendungen kombiniert werden
Welche Prozesse sollen verbessert werden?
Copilot reicht oft: E-Mails, Dokumente, Präsentationen und Meetings Eigene Lösung interessant: Dokumentenverarbeitung, Prüfungen, Routing, Entscheidungen und Workflows
Wie sensibel sind die Daten?
Copilot kann reichen: Normale Geschäfts- und Bürodaten mit passenden Sicherheitsvorgaben Eigene Architektur prüfen: Besonders sensible, regulierte oder stark abgeschottete Daten
Wie viele Nutzer brauchen KI?
Copilot kann reichen: Viele Mitarbeiter sollen allgemeine Aufgaben schneller erledigen Eigene Lösung interessant: Wenige Nutzer bearbeiten einen klar definierten, wertschöpfenden Prozess
Wie wichtig sind Nachvollziehbarkeit und Prozesskontrolle?
Copilot kann reichen: Unterstützung bei individuellen Wissens- und Produktivitätsaufgaben Eigene Lösung interessant: Dokumentierte Prozessschritte, definierte Entscheidungen, Auditierbarkeit und Freigaben
Es muss kein Entweder-oder sein
In der Praxis ist die beste Lösung häufig eine Kombination aus Microsoft Copilot und individuellen KI-Anwendungen.
Copilot kann die allgemeine Produktivität im Büro verbessern. Eine eigene KI-Lösung kann sich gleichzeitig um die zwei oder drei Prozesse kümmern, bei denen tatsächlich ein großer wirtschaftlicher Hebel besteht.
Ein Versicherungsunternehmen kann Copilot beispielsweise für E-Mails, Dokumente und Meeting-Zusammenfassungen einsetzen. Die Verarbeitung von Schadensmeldungen kann dagegen über eine individuelle Dokumenten-KI laufen, die Meldungen klassifiziert, relevante Daten extrahiert, auf Vollständigkeit prüft und die Informationen an das Fachsystem übergibt.
Ein Logistikunternehmen kann Copilot für Berichte und Zusammenfassungen nutzen. Die Rechnungsprüfung gegen Bestellungen und Lieferscheine kann dagegen über eine individuelle Automatisierung laufen, weil dort mehrere Systeme und spezifische Geschäftsregeln zusammenspielen.
Genau diese Kombination ist häufig sinnvoller als die Frage „Copilot oder eigene KI?“ isoliert zu betrachten.
Was kostet Microsoft Copilot im Vergleich zu einer eigenen KI-Lösung?
Die Kostenfrage lässt sich nicht pauschal beantworten. Bei Microsoft Copilot sind die Lizenzkosten vergleichsweise einfach zu kalkulieren. Bei einer eigenen KI-Lösung müssen dagegen Entwicklung, Infrastruktur, Modellkosten, Integration und laufender Betrieb berücksichtigt werden.
Der entscheidende Punkt ist deshalb nicht der Preis pro Nutzer oder pro API-Aufruf. Entscheidend ist der Business Case.
Wenn 300 Mitarbeiter mit Copilot jeweils nur wenige Minuten pro Tag sparen, kann die Investition trotzdem sinnvoll sein. Wenn dagegen ein individueller KI-Agent einen zeitaufwendigen Prozess für fünf Sachbearbeiter automatisiert und Fehler reduziert, kann eine eigene Lösung wirtschaftlich attraktiver sein.
Die richtige Frage lautet deshalb: Welche Lösung erzeugt für diesen konkreten Prozess den größeren messbaren Nutzen?
Wann lohnt sich eine eigene KI-Lösung?
Eine individuelle KI-Lösung wird besonders interessant, wenn mehrere dieser Punkte zusammenkommen:
Der Prozess ist für das Unternehmen wirtschaftlich relevant.
Mehrere interne Datenquellen müssen miteinander kombiniert werden.
Es gibt klare Regeln und wiederkehrende Prozessschritte.
Dokumente müssen automatisch klassifiziert, extrahiert oder geprüft werden.
Die KI soll Aktionen in bestehenden Systemen auslösen.
Ein hoher manueller Aufwand soll reduziert werden.
Die Anforderungen an Datenhaltung, Zugriffsrechte oder Compliance gehen über einen Standardassistenten hinaus.
Wenn dagegen hauptsächlich E-Mails, Meetings, Präsentationen, Texte und Tabellen schneller bearbeitet werden sollen, ist Microsoft Copilot häufig der einfachere und sinnvollere Einstieg.
So finden Sie heraus, was für Ihr Unternehmen passt
Bevor Sie Copilot-Lizenzen für die gesamte Belegschaft kaufen oder direkt ein eigenes KI-Entwicklungsprojekt starten, sollten Sie zuerst verstehen, wo der größte Hebel liegt.
Bei Pilicore gehe ich deshalb nicht von der Technologie aus, sondern vom Prozess.
Discovery. Wir schauen uns Ihre konkreten Prozesse an. Welche Dokumente fließen wohin? Wo werden Daten manuell übertragen? Wo warten Vorgänge auf Freigaben? Welche Systeme sind beteiligt?
Bewertung. Für jeden relevanten Prozess prüfen wir, ob Microsoft Copilot ausreicht, ob eine individuelle KI-Lösung sinnvoll ist oder ob klassische Automatisierung die bessere Lösung wäre.
Proof of Concept. Für den vielversprechendsten Use Case bauen wir einen funktionierenden Prototyp. Kein Slide Deck, sondern echte Software, die mit realistischen Daten und dem tatsächlichen Prozess arbeitet.
Danach haben Sie eine fundierte Grundlage für die Entscheidung. Nicht basierend auf Marketing-Versprechen, sondern auf Ihren eigenen Prozessen, Daten und wirtschaftlichen Anforderungen.
Fazit: Copilot oder eigene KI?
Microsoft Copilot ist für viele Unternehmen ein sinnvoller Einstieg in generative KI. Besonders dann, wenn die Mitarbeiter hauptsächlich mit Microsoft 365 arbeiten und allgemeine Produktivitätsaufgaben beschleunigt werden sollen.
Eine eigene KI-Lösung lohnt sich dagegen dort, wo es um spezifische Geschäftsprozesse, mehrere Datenquellen, individuelle Regeln, Automatisierung oder besondere Anforderungen an Daten und Prozesskontrolle geht.
Und häufig ist die beste Antwort weder Copilot noch eigene KI, sondern beides.
Die entscheidende Frage ist deshalb nicht: „Welche KI sollen wir kaufen?“ Sondern: „Welches konkrete Problem wollen wir mit KI lösen und welche Architektur passt dazu?“
Genau diese Frage sollte am Anfang jedes KI-Projekts stehen.
Stehen Sie vor der Frage, ob sich Microsoft Copilot für Ihr Unternehmen rechnet oder ob eine maßgeschneiderte Lösung für interne Daten und Prozesse besser passt? In 15 Minuten kläre ich unverbindlich, welcher Weg zu Ihrer IT-Architektur passt. Zum Erstgespräch.
Cookies & Datenschutz
Diese Seite verwendet notwendige Cookies für den Betrieb. Optionale Analytics-Cookies setze ich nur mit Ihrer Einwilligung. Mehr erfahren
NotwendigErforderlich für Grundfunktionen und Speicherung Ihrer Cookie-Wahl.
AnalyticsOptionale Nutzungsstatistik mit Google Analytics (nur wenn Sie zustimmen).